

Tối ưu chi phí Claude API: Giảm bill hiệu quả với | RevidAPI

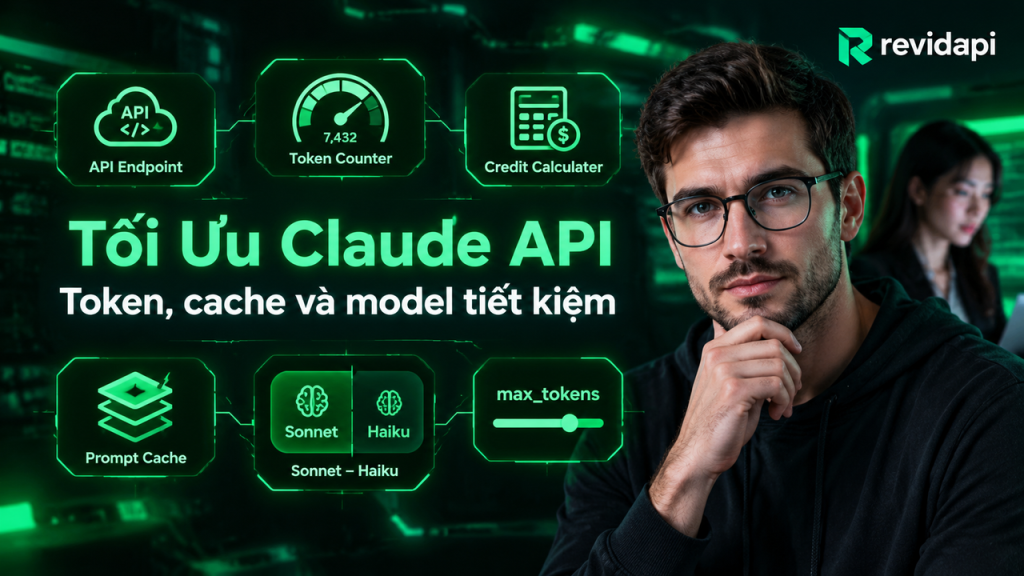
Bạn có thể giảm chi phí Claude API bằng cách đo input/output token, cache prompt lặp lại, chọn Sonnet hoặc Haiku theo nhiệm vụ và đặt `max_tokens` vừa đủ. Bài này giúp bạn lập quy trình theo dõi chi phí theo từng workflow, thay vì ước lượng từ số người dùng. Bạn sẽ biết phần nào trong system prompt nên giữ cố định, khi nào một request không cần phản hồi real-time để cân nhắc Message Batches API, và vì sao token tiếng Việt có dấu cần được đo bằng dữ liệu thực tế. Một nguồn SERP tham khảo nêu prompt caching có thể giảm chi phí trong trường hợp phần input lặp lại; đây là mức tham khảo, không phải cam kết cho mọi workflow.
Tóm tắt nhanh
- Ghi riêng input token và output token cho từng request trước khi đổi model hoặc rút ngắn prompt.
- Dùng cache cho system prompt hoặc tài liệu lặp lại; mức giảm đến 90% chỉ áp dụng theo điều kiện sử dụng cụ thể được nguồn
tham khảo nêu.
- Chọn Haiku cho tác vụ nhẹ, Sonnet cho yêu cầu khó hơn và đặt `max_tokens` theo độ dài đầu ra cần nhận, thay vì để dư.
Tối ưu chi phí Claude API là gì?
Một request Claude không có giá cố định: ngân sách thay đổi theo input token, output token, model và số lần gọi. Vì vậy, 1.000 người dùng chưa nói lên nhiều nếu mỗi người chỉ gửi một câu ngắn, trong khi một workflow xử lý tài liệu có thể gửi lại system prompt, lịch sử chat và văn bản dài ở mỗi request.
Hiểu đúng trước khi tính Tối ưu chi phí Claude API là đo lượng token
của từng workflow rồi điều chỉnh cách gọi. Bạn có thể giữ phần prompt lặp lại trong cơ chế cache, chọn Sonnet cho tác vụ cần suy luận nhiều, Haiku cho phân loại hoặc trả lời ngắn, và đặt `max_tokens` theo độ dài đầu ra thật sự cần. Mức tiết kiệm cụ thể phải đo trên log của bạn; một nguồn SERP đề cập khả năng giảm đến 90% nhờ prompt caching, nhưng đây không phải con số áp dụng cho mọi request. Credit cũng không nên được xem như đơn vị cố định. Bạn cần quy đổi credit theo số input token, output token, model và đơn giá hiện hành của nền tảng đang dùng; hãng có thể thay đổi bảng giá hoặc quy tắc quy đổi. Với nội dung tiếng Việt có dấu, số token có thể khác dự đoán từ số ký tự, nên việc đo thực tế quan trọng hơn ước lượng bằng mắt. API pay-per-token và gói subscription phục vụ hai kiểu dùng khác nhau. API phù hợp khi bạn kiểm soát từng request trong chatbot, backend hoặc pipeline xử lý dữ liệu; subscription tính theo gói và giới hạn sử dụng riêng. Ngân sách nên lấy từ số request, token trung bình và model của từng workflow, không chỉ từ số tài khoản người dùng.
Claude API tính chi phí qua những thành phần nào?
Workflow tối ưu chi phí Claude API: cache, chọn model và giới hạn output
Một request dài chưa chắc tốn vì phần trả lời; nếu system prompt 4.000 token được gửi lại trong 1.000 request, chính đoạn cố định đó cần được kiểm tra trước. Quy trình nên ghi riêng input token, output token, model và loại tác vụ để biết tiền phát sinh ở đâu.
Quy trình 6 bước
| Bước | Mô tả | API / Node | Ghi chú |
|---|---|---|---|
| 1 | Ghi nhận token đầu vào và đầu ra | Token usage, log node | |
| 2 | Phân tách prompt cố định, biến động | System prompt, input mapper | |
| 3 | Kiểm tra khả năng cache phần lặp lại | Prompt caching | |
| 4 | Phân loại nhiệm vụ theo độ khó | Model router | |
| 5 | Giới hạn độ dài phản hồi | `max_tokens` | |
| 6 | Tổng hợp chi phí theo quy trình | Usage log, dashboard | Sau 7 ngày log, hãy so sánh từng nhóm workflow thay vì nhìn tổng tiền tháng. Ví dụ, nếu `classify` dùng Haiku nhưng retry cao hơn, mức đơn giá thấp chưa đủ để kết luận rẻ hơn; cần tính cả output token và số lần gọi lại. |
Cache, model rẻ và giới hạn output có những giới hạn nào?
Các giới hạn cần kiểm tra Prompt caching chỉ có tác dụng khi một phần input
được lặp lại, chẳng hạn system prompt chứa quy tắc xử lý hoặc tài liệu hướng dẫn cố định. Nếu mỗi request đều thay đổi gần như toàn bộ prompt, phần được cache rất nhỏ và chi phí khởi tạo cache có thể không đáng để dùng. Một bài tham khảo SERP nêu mức giảm đến 90%, nhưng đây không phải mức đảm bảo cho mọi workflow; hãng và tài liệu API chính thức vẫn là nguồn cần kiểm tra. `max_tokens` không phải con số càng thấp càng tốt. Đặt giới hạn 100 token cho tác vụ cần trả về JSON gồm nhiều trường có thể làm câu trả lời bị cắt, thiếu dữ liệu hoặc lỗi cú pháp. Bạn nên kiểm tra trạng thái kết thúc
của response và tăng giới hạn khi output thực tế thường chạm trần, thay vì áp một giá trị chung cho mọi loại request. Chọn Haiku thay Sonnet cũng có chi phí phụ. Với yêu cầu phân loại ngắn, model rẻ hơn có thể phù hợp; nhưng nếu câu trả lời sai khiến hệ thống phải retry, chạy thêm bước hậu kiểm hoặc để người vận hành sửa thủ công, tổng chi phí workflow có thể tăng. Chúng tôi chưa có dữ liệu để đưa ra tỷ lệ tiết kiệm cố định cho từng model. Token tiếng Việt có dấu cần được đo bằng công cụ tokenizer hoặc usage trả về từ API, không suy ra từ số ký tự. Cùng một đoạn 500 ký tự có thể tạo lượng token khác nhau tùy nội dung. Vì đơn giá, điều kiện cache và giới hạn model có thể thay đổi, hãy ghi log input token, output token và số lần retry trước khi kết luận cách nào rẻ hơn.
Ứng dụng tối ưu chi phí Claude cho doanh nghiệp và creator Việt Nam
Chatbot nội bộ và quy trình doanh nghiệp Với chatbot nội bộ, bạn có thể giữ system prompt chứa quy định trả lời, quy trình nghỉ phép hoặc tài liệu hỗ trợ ở phần cố định, rồi chỉ gửi câu hỏi và dữ liệu nhân viên ở mỗi request. Nếu cùng một prompt dài
được gọi hàng trăm lần, hãy kiểm tra khả năng prompt caching thay vì gửi lại nguyên khối. Hãng tham khảo trong SERP nêu mức giảm đến 90% cho phần lặp lại, nhưng đây không phải mức có thể áp dụng mặc định cho mọi workflow. Marketing nên tách bước phân loại brief khỏi bước viết nội dung. Một model nhẹ như Haiku có thể gắn nhãn brief theo kênh, ngôn ngữ và mức độ cần duyệt; Sonnet chỉ nhận các brief cần suy luận, giữ giọng thương hiệu hoặc xử lý nhiều điều kiện. Trong n8n, ghi `input_tokens`, `output_tokens`, model và trạng thái retry vào từng node để biết chi phí phát sinh ở bước phân loại, tạo bản nháp hay duyệt nội dung. Tác vụ cần trả lời ngay chạy đồng bộ; việc tạo metadata cho 1.000 sản phẩm có thể gom thành batch nếu không cần phản hồi real-time.
Creator và automation Creator có thể đặt `max_tokens` theo đầu ra thay vì để một giới hạn lớn cho mọi prompt. Ví dụ, caption TikTok chỉ cần 120–180 từ thì yêu cầu rõ cấu trúc và giới hạn đầu ra; kịch bản video 60 giây cần giới hạn khác. Với metadata cho 20 video, lưu token theo từng job để phát hiện prompt nào khiến Claude lặp lại phần mở đầu hoặc sinh thêm biến thể không cần thiết. Một nhóm marketing giả định dùng Haiku để phân loại brief, chuyển riêng brief phức tạp sang Sonnet, đồng thời tách hướng dẫn thương hiệu lặp lại khỏi dữ liệu chiến dịch để kiểm tra caching. Họ ghi log theo node, loại nội dung và người duyệt, thay vì chỉ nhìn tổng chi phí cuối tháng. Cách này chưa chứng minh một mức tiền tiết kiệm cụ thể, nhưng cho thấy chính xác bước nào cần đổi model, rút prompt hoặc giảm `max_tokens`.
Pro-tips kiểm soát chi phí với RevidAPI
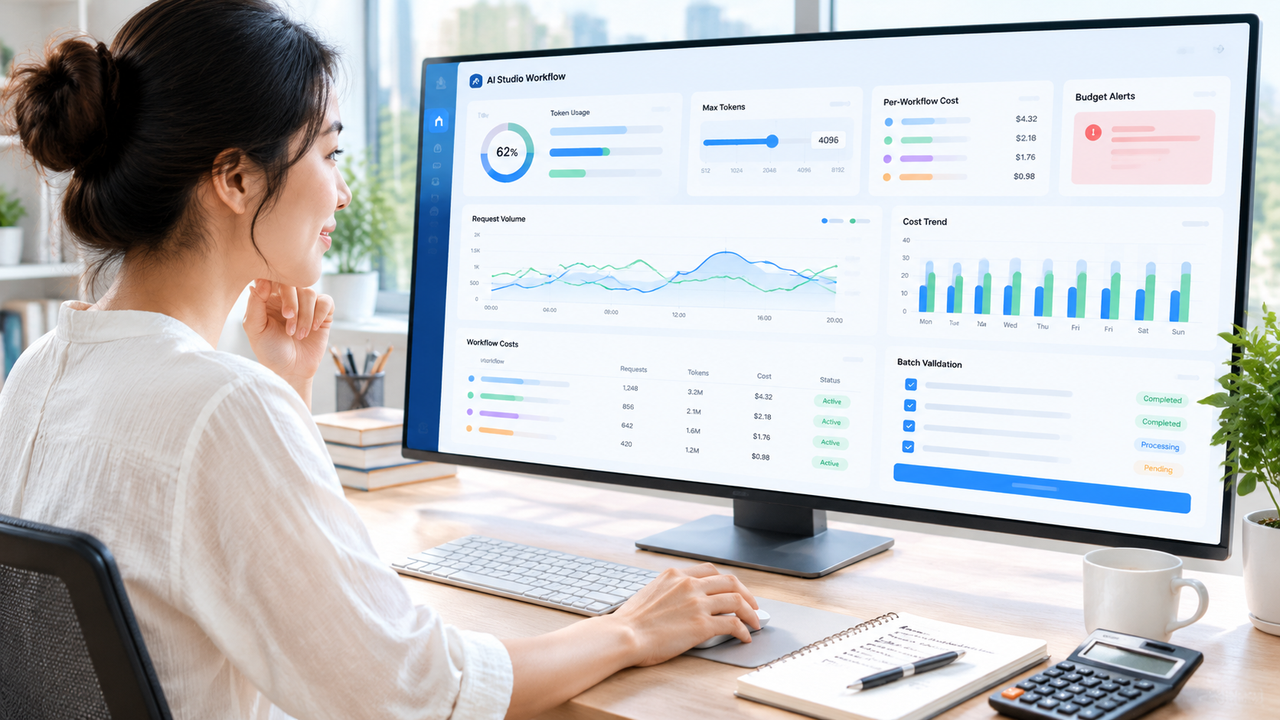
Bạn có thể kiểm soát chi phí Claude qua RevidAPI bằng cách đo token, đặt `max_tokens` theo đầu ra cần dùng và ghi chi phí theo từng workflow, thay vì chỉ nhìn tổng credit cuối tháng.
Kiểm tra trước khi chạy hàng loạt Trong AI Studio Workflow, hãy chạy thử một request với dữ liệu đại diện rồi ghi lại model, input token, output token, `max_tokens`, thời gian phản hồi và chi phí. Với prompt lặp lại, tách phần system prompt cố định khỏi dữ liệu động để kiểm tra điều kiện prompt caching; đừng mặc định mọi request đều
được cache. Một nguồn SERP nêu mức giảm đến 90%, nhưng đây không phải mức RevidAPI hay Claude cam kết cho workflow
của bạn. Bạn có thể tách các nhánh phân loại, viết nội dung, TTS và video trong n8n Hosting. Nhánh phân loại dùng model có trong danh sách trả về từ `GET /v1/chat/models`; nhánh viết dài mới cân nhắc model đắt hơn. Ghi log theo `workflow_id` và `request_id` để biết credit phát sinh ở bước nào. Với tác vụ không cần phản hồi tức thì, hãy kiểm tra khả năng dùng batch trong tài liệu hiện hành trước khi triển khai, vì điều kiện và giá có thể thay đổi.
Gọi Claude qua RevidAPI Kiểm tra API key tại API Marketplace, xem model và giá bằng `GET https://revidapi.com/v1/chat/models`, rồi thử request nhỏ sau:
curl -X POST "https://revidapi.com/v1/chat/completions" \ -H "x-api-key: $REVIDAPI_KEY" \ -H "Content-Type: application/json" \ -d '{"model":"claude-sonnet-5","messages":[{"role":"user","content":"Nội dung cần xử lý"}],"max_tokens":300}'
curl -X POST "https://revidapi.com/v1/chat/completions" \ -H "x-api-key: $REVIDAPI_KEY" \ -H "Content-Type: application/json" \ -d '{"model":"claude-sonnet-5","messages":[{"role":"user","content":"Nội dung cần xử lý"}],"max_tokens":300}'`max_tokens: 300` chỉ là ví dụ; nếu đầu ra cần 80 token, đặt giới hạn gần 80 rồi đo lại tỷ lệ bị cắt. Theo dõi credit và lịch sử tại Dashboard Usage, đồng thời đối chiếu Bảng giá AI Studio. RevidAPI giúp gom việc gọi model và theo dõi usage, nhưng không thay bạn quyết định prompt nào đủ ổn định để cache.
Câu hỏi thường gặp về tối ưu chi phí Claude API
Claude API tính phí theo gì?
Chi phí chủ yếu đến từ input token, output token, model và số lần gọi. Vì vậy, cùng một prompt nhưng chạy bằng Haiku và Sonnet có thể tạo ngân sách khác nhau; hãy ghi lại usage theo từng request thay vì lấy số người dùng làm cơ sở duy nhất.
Prompt caching có phải lúc nào cũng giảm chi phí không?
Không. Caching chỉ có ý nghĩa khi system prompt hoặc tài liệu đầu vào
được lặp lại giữa nhiều request; nếu nội dung thay đổi liên tục, phần được cache ít và phí phát sinh có thể không bù được điều kiện liên quan
của API. Một nguồn SERP tham khảo nêu mức giảm đến 90%, nhưng đây không phải con số áp dụng cho mọi workflow và cần kiểm tra lại tài liệu Claude hiện hành.
Khi nào nên chọn Haiku thay vì Sonnet?
Chọn Haiku cho việc ngắn, lặp lại như phân loại ticket, trích trường JSON hoặc kiểm tra nhãn. Dùng Sonnet khi request cần suy luận nhiều bước, xử lý tài liệu dài hoặc tạo bản nháp cần ít sửa hơn; quyết định nên dựa trên log token, tỷ lệ retry và chất lượng đầu ra
của chính workflow.
Đặt `max_tokens` thấp có an toàn không?
Chỉ khi giới hạn vẫn đủ cho đầu ra cần nhận. Ví dụ, tác vụ trả về 5 nhãn JSON có thể dùng giới hạn thấp hơn bài phân tích 1.500 từ; đặt quá thấp
sẽ làm câu trả lời bị cắt hoặc thiếu trường bắt buộc, khiến bạn phải gọi lại và phát sinh thêm output token.
Credit RevidAPI có giống token Claude không? Không nhất thiết. Credit là đơn vị quy đổi
của RevidAPI, còn Claude tính theo token, model và cách gọi; hãy đối chiếu đơn giá, quy tắc quy đổi và lịch sử usage trong dashboard trước khi lập ngân sách, vì chưa có dữ liệu ở đây để khẳng định một credit tương đương bao nhiêu token Claude. Với workflow không cần phản hồi tức thời, bạn cũng nên kiểm tra Message Batches API và mức giá hiện hành trong tài liệu chính thức trước khi chuyển luồng xử lý. Đừng dùng mức 50% được nêu trong một bài SERP làm cam kết ngân sách nếu chưa chạy thử trên dữ liệu thật.
Khám phá workflow miễn phí tại AI Tạo ảnh & Video và lấy API key tại API Marketplace RevidAPI.
Khám phá API Marketplace RevidAPI — lấy API key miễn phí · Nhóm Zalo hỗ trợ · revidapi@gmail.com