


Lồng tiếng video bằng AI cần giữ mốc bắt đầu, kết thúc từng câu và căn độ dài giọng đọc trong khoảng đó để lời xuất hiện đúng lúc. Chẳng hạn, câu dành cho đoạn 00:05–00:08 chỉ có khung 3 giây. Tổng audio dài bằng video vẫn chưa bảo đảm từng câu bám đúng hình. Khớp thời gian cũng không đồng nghĩa với khớp khẩu hình: lời có thể vào đúng cảnh nhưng chuyển động miệng vẫn khác âm đang phát. Bài viết hướng dẫn bạn chuẩn bị video cùng phụ đề có timestamp, kiểm tra từng đoạn và xử lý câu đọc dài hơn khung cho phép. Bạn sẽ biết cần đối chiếu gì trước khi ghép, khi nào nên sửa lời hoặc tạo lại giọng, thay vì chỉ nghe bản xuất từ đầu đến cuối rồi dò chỗ lệch.
Tóm tắt nhanh
- Giữ cả `start` và `end` cho từng câu, không chỉ tổng thời lượng bản thu.
- So độ dài audio từng đoạn với `end − start` để tìm câu vượt khung.
- Kiểm tra riêng khẩu hình nếu video có người nói trực diện trước máy quay.
Lồng tiếng video bằng AI khớp thời gian hoạt động thế nào?
Một câu được cấp khung từ giây 0 đến giây 3 chỉ có 3 giây để phát. Trong dữ liệu đoạn thoại, `start` là mốc bắt đầu, `end` là mốc kết thúc; thời lượng được cấp bằng `end − start`. Bản thu của câu phải được đối chiếu với khung này, thay vì chỉ so độ dài toàn bộ audio với video.
Hai câu vừa video vẫn có thể lệch hình Ví dụ giả định: video dài 10 giây, câu A thuộc khung 0–3 giây, câu B thuộc khung 3–6 giây. Nếu A đọc mất 4 giây và B
được nối ngay sau A, timeline
sẽ như sau:
- Audio nối câu: A [0–4]: B [4–7] — lặng [7–10]Bản audio vẫn dài 10 giây nhờ khoảng lặng cuối. Nhưng A lấn sang khung B, còn B bắt đầu muộn 1 giây. Nếu giữ B ở đúng giây 3, hai câu sẽ chồng tiếng trong khoảng 3–4 giây.
Ba kiểu khớp cần phân biệt Căn điểm bắt đầu đặt B vào giây 3. Căn độ dài giữ phần đọc B trong khung 3–6 giây. Đồng bộ khẩu hình còn phải làm chuyển động miệng tương ứng với âm đang phát; công cụ chỉ tạo giọng không mặc nhiên có khả năng này. Với ví dụ trên, đầu ra cần kiểm tra là vị trí phát và khoảng phát thực tế
của từng câu: A có dừng trước giây 3, B có bắt đầu đúng giây 3 và kết thúc trước giây 6 không?
Năm thành phần giúp lời lồng tiếng bám sát hình
Nếu một câu đọc sai tên sản phẩm, bạn có sửa và tạo lại riêng câu đó không? Trước khi chọn công cụ, hãy kiểm tra quyền can thiệp ở từng thành phần: sửa văn bản, lấy audio riêng và điều chỉnh bản ghép.
Kiểm tra đầu vào, đầu ra và quyền sửa Dùng bảng này để đánh giá công cụ. Cột giữa chỉ rõ dữ liệu đi vào và kết quả cần lấy ra; cột cuối là thao tác bạn nên thử trực tiếp.
| Thành phần | Vai trò: đầu vào → đầu ra | Cần kiểm tra |
|---|---|---|
| Phụ đề hoặc transcript có timestamp | Lời thoại nguồn → các đoạn văn bản có mốc thời gian | Có xuất được nội dung và mốc thời gian không? |
| Biên tập bản dịch theo khung | Câu gốc và khung thời gian → câu dịch để tạo giọng | Có sửa riêng từng câu được không? |
| Tạo giọng theo từng đoạn | Văn bản từng câu → audio tương ứng | Có lấy lại file của từng đoạn không? |
| Đo audio, chèn khoảng lặng, căn vị trí | Audio và timestamp → lời thoại trên timeline | Có xem và điều chỉnh kết quả ghép không? |
| Nghe cùng nhạc nền, hiệu ứng | Giọng và âm thanh nền → bản phối để nghe kiểm tra | Lời có bị nền che hoặc chuyển đoạn đột ngột không? |
Workflow 7 bước lồng tiếng AI giữ timestamp
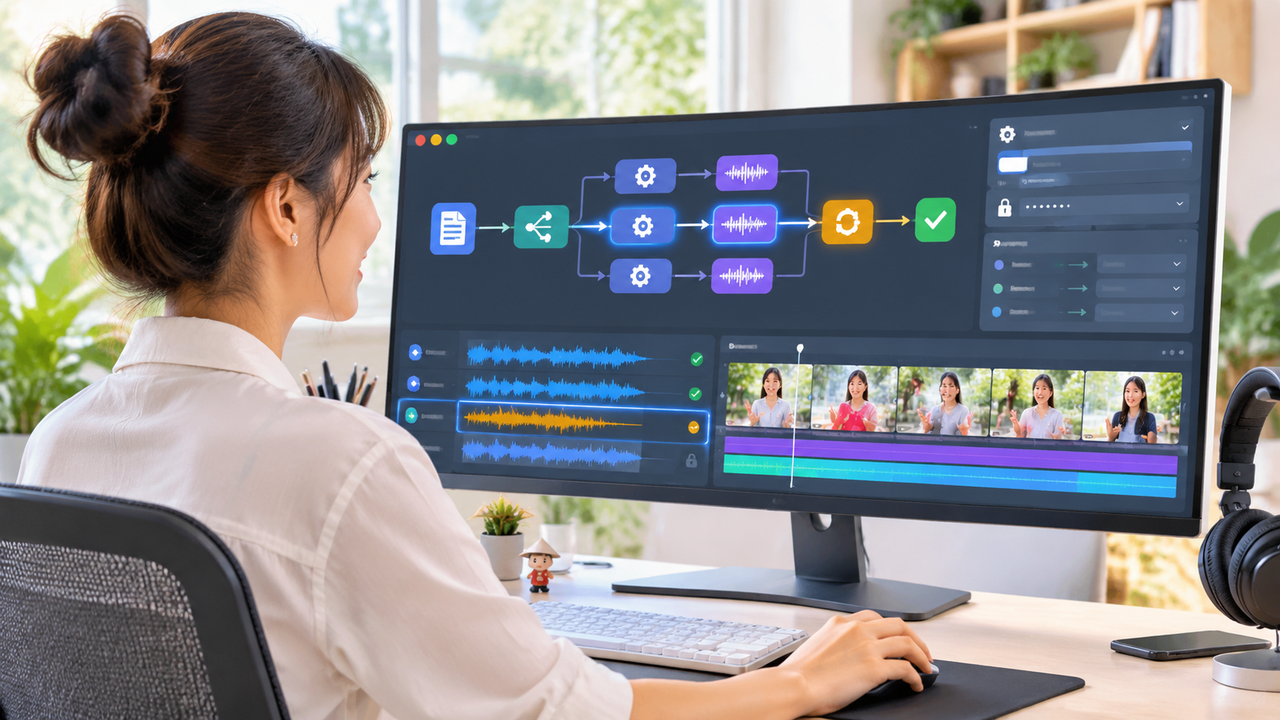
Một câu tạo giọng bị dài không nên kéo lệch cả phần còn lại. Bạn cần giữ `id`, `start`, `end` xuyên suốt quy trình, lưu riêng video và SRT gốc để đối chiếu ở mỗi lần sửa. n8n điều phối dữ liệu; công cụ media đo, ghép âm thanh; người biên tập duyệt lời và bản xuất.
Thực hiện từng bước, kiểm tra trước khi chuyển tiếp
| Bước | Hành động | Công cụ phụ trách | Điểm kiểm tra |
|---|---|---|---|
| 1. Chuẩn hóa đầu vào | Đưa video và SRT vào thư mục dự án; giữ bản gốc chỉ đọc, tạo bản làm việc. | n8n đọc file hoặc nguồn lưu trữ đã cấu hình. | Mở video, đối chiếu câu đầu và cuối với SRT. Nếu thiếu phụ đề, bổ sung trước; không mặc định có API nhận diện lời nói. |
| 2. Kiểm tra timestamp | Chuyển mốc sang cùng đơn vị; kiểm tra `start < end`, thứ tự câu, chồng lấn và `end − start`. | Code node trong n8n. | Xuất danh sách đoạn lỗi theo `id`; người biên tập duyệt chỗ chồng lấn trước khi tiếp tục. |
| 3. Biên tập lời Việt | Sửa câu theo khung thời gian, giữ ý chính, tên riêng và sắc thái; giữ nguyên `id`, `start`, `end`. | Người biên tập. | Đối chiếu từng câu với lời gốc, đánh dấu bản lời đã duyệt. |
| 4. Tạo giọng từng đoạn | Gửi riêng từng câu tới dịch vụ TTS đã chọn; lưu file và ánh xạ `id` với đường dẫn audio. | HTTP Request trong n8n. | Kiểm tra đủ file, mở nghe được; ghi đoạn lỗi để chạy lại đúng câu. |
| 5. Đo độ dài | Đo audio bằng `ffprobe`, so với `end − start`; sửa lời hoặc tạo lại câu vượt khung. | Môi trường media cấu hình riêng; người biên tập sửa lời. | Lưu thời lượng đo theo `id`; chỉ chuyển câu đã vừa khung. |
| 6. Ghép timeline | Đặt từng audio tại `start` tuyệt đối, giữ khoảng lặng và phối nền đã chuẩn bị. | FFmpeg hoặc phần mềm dựng. | Nghe chỗ nối câu, kiểm tra lời không lấn đoạn kế tiếp. |
| 7. Duyệt và xuất | Xem toàn bộ video, đối chiếu bản gốc và log thời lượng; xuất bản đã duyệt. | Người biên tập và dữ liệu đo. | Kiểm tra lại file xuất, nhất là đoạn từng sửa hoặc tạo lại. |
Không nối câu theo điểm kết thúc file trước Ví dụ, câu B có `start = 12,000` giây thì vẫn đặt tại đó, dù file câu A kết thúc ở giây 11,700 hay 12,200. Nếu A lấn khung, quay lại bước 5; nối B ngay sau A
sẽ truyền sai lệch sang câu sau. Lượt duyệt này kiểm tra thời gian, không xác nhận khớp khẩu hình.
Chi phí xử lý lại và những trường hợp khó căn thời gian
Một câu bị gán sai `start` hoặc `end` có thể kéo theo việc tạo lại giọng, căn lại audio và xuất lại video. Nếu timestamp nguồn sai, bản thu đọc đúng lời vẫn xuất hiện sai cảnh. Cần sửa mốc trước khi trả tiền cho lượt tạo tiếp theo.
Những đoạn dễ phải làm lại Câu tiếng Việt nhiều âm tiết hoặc chứa tên sản phẩm dài có thể khó nghe khi tăng tốc để vừa khung. Ví dụ, lời giới thiệu kèm mã hàng cần
được nghe thử cả phát âm lẫn nhịp đọc; vừa thời lượng chưa có nghĩa là đạt. Khi hai khách mời chen lời, bạn cần xử lý riêng theo người nói và nghe lại chỗ chồng giọng. Nguồn thu khó nghe hoặc cảnh cần diễn xuất tinh tế nên có biên tập viên can thiệp. Tách kiểm tra cảm xúc, phát âm khỏi kiểm tra thời lượng: câu vừa khung vẫn có thể đọc sai tên người. Tách giọng khỏi nhạc có thể để lại tiếng giọng cũ hoặc làm nhạc bị méo. Với cảnh có nhạc dưới lời thoại, hãy nghe cả đoạn chuyển từ có lời sang không lời trước khi duyệt.
Tính chi phí đến bản
được duyệt Chưa có mức phí được xác minh trong dữ liệu bài này. Khi triển khai, bạn cần kiểm tra bảng giá hiện hành
| Tạo lại | Sửa một câu có bị tính thêm phí không? |
|---|---|
| Hạ tầng media | Đo, ghép, xuất và lưu file phát sinh phí gì? |
Bạn cũng cần tính thời gian người duyệt nghe lại câu sửa trong cảnh gốc, kể cả khi lượt tạo lại không mất phí.
Hai tình huống tại Việt Nam: video sản phẩm và bài giảng
Marketer làm video sản phẩm Giả sử shop gia dụng dành khung `00:08–00:12` để giới thiệu nồi cơm, nhưng câu lồng tiếng dài 5 giây. Đây là ví dụ giả định: audio vượt khung 4 giây và có thể kéo lời giới thiệu sang cảnh hiển thị nút mua. Bạn thử rút câu “Chiếc nồi cơm thương hiệu [tên hãng] này hiện đang có giá bán là 790.000 đồng, hãy đặt mua ngay hôm nay” thành “[Tên hãng], giá 790.000 đồng. Đặt mua ngay”. Giữ tên thương hiệu, số tiền và lời kêu gọi mua; bỏ phần diễn đạt dư rồi tạo lại giọng. Chưa đo audio mới thì chưa thể kết luận câu đã vừa khung. Khi nghe bản ghép, bạn kiểm tra cách đọc tên hãng và “bảy trăm chín mươi nghìn đồng”. Nếu lời “đặt mua” vang lên
sau khi nút mua biến mất, câu vẫn cần sửa dù nghe riêng có vẻ tự nhiên.
Creator làm bài giảng tiếng Việt Với bài hướng dẫn Excel, câu “Chọn vùng dữ liệu rồi bấm Insert” cần đi cùng thao tác trên màn hình. Bạn đánh dấu câu nào đọc “Insert” trước khi con trỏ tới nút, hoặc còn giải thích biểu đồ cũ khi slide mới đã xuất hiện. Trước khi tạo lại giọng, bạn thống nhất cách đọc thuật ngữ và chữ viết tắt, chẳng hạn “SQL” trong toàn bài. Sau đó nghe lại đoạn chuyển slide cùng câu liền trước và liền sau để phát hiện lời bị dồn hoặc ngắt giữa ý.
- Để đối chiếu hai tình huống, mỗi câu dùng một bản ghi: `tình huống — mã câu — start/end — thời lượng trước — thời lượng sau — nhận xét nghe`. Chỉ điền thời lượng
sau khi đo file thật; nhận xét nên cụ thể như “đọc hết giá trước khi đổi cảnh”. Chúng tôi chưa có số đo thực nghiệm để điền bảng trước–sau.
Gọi RevidAPI trong n8n và quản lý từng đoạn audio
Nếu chỉ câu `seg_012` cần sửa, bạn nên tạo lại đúng câu đó và giữ audio đã duyệt của các đoạn còn lại. Trong n8n, hãy dùng mã đoạn làm khóa liên kết giữa kịch bản, yêu cầu tạo giọng và file kết quả.
Xác minh hợp đồng API trước khi cấu hình Brief đề xuất `https://revidapi.com/v1/tts`, nhưng endpoint này chưa có trong danh sách API đã xác minh
được cung cấp. Vì vậy, chưa đủ cơ sở để viết mẫu gọi chạy được hoặc khẳng định response trả URL, file nhị phân hay mã tác vụ. Bạn cần kiểm tra hợp đồng request và response trong tài liệu Dashboard trước khi triển khai. Trang Text to Speech tiếng Việt là nơi tham khảo công cụ tạo giọng; không thay thế tài liệu API. Danh sách API được cung cấp xác nhận header chung `x-api-key: YOUR_API_KEY`, nhưng chưa xác nhận payload TTS, giá credit hay giới hạn độ dài văn bản.
Cấu hình HTTP Request và lưu từng đoạn
- Tạo bản ghi nội bộ trước khi gửi. Lưu các trường sau trong kho dữ liệu bạn dùng cùng n8n. Đây là cấu trúc điều phối đề xuất, không phải schema của nhà cung cấp.
| Nhóm trường | Cách dùng trong workflow |
|---|---|
| `id`, `start`, `end` | Liên kết audio với đúng đoạn trên timeline |
| `text`, `script_version` | Ghi nhận chính xác bản lời đã gửi |
| `audio_duration`, `audio_version`, `check_status` | Theo dõi bản audio và kết quả kiểm tra |
Phân biệt các nơi thao tác Bạn cấu hình HTTP Request trong n8n. Hub Workflow là nơi tham khảo tài nguyên workflow n8n; AI Studio Workflow là điểm truy cập riêng, không phải giao diện n8n. AI Dubbing & Vietsub phục vụ tham khảo nhu cầu lồng tiếng và phụ đề; tên dịch vụ không xác nhận hợp đồng TTS ở trên.
Câu hỏi thường gặp trước khi thử lồng tiếng AI
Lồng tiếng video bằng AI có tự khớp thời gian không?
Tùy công cụ; tạo giọng từ văn bản chưa bảo đảm câu nói nằm đúng đoạn hình. Bạn cần kiểm tra cả mốc bắt đầu, kết thúc từng câu và độ dài audio trong khung đó, kể cả khi tổng bản thu vừa video.
Làm gì khi câu lồng tiếng dài hơn đoạn hình?
Bạn nên rút gọn lời nhưng giữ ý chính, rồi tạo lại riêng câu bị dài. Chẳng hạn, câu đọc tràn sang cảnh kế tiếp cần
được sửa và nghe lại cùng hình; đẩy mốc kết thúc có thể làm lệch câu sau.
Có thể lồng tiếng từ SRT và giữ timestamp không? Có, nếu quy trình giữ mốc
của từng mục SRT và dùng chúng để đặt audio lên timeline. Giữ nguyên timestamp trong file phụ đề chưa đủ: bạn vẫn phải đo audio và kiểm tra từng câu có vừa khoảng `end − start` hay không.
Khớp thời gian có giống khớp khẩu hình không?
Không. Khớp thời gian đặt câu nói vào đúng khoảng hình; khớp khẩu hình còn cần chuyển động miệng phù hợp với lời mới. Một câu bắt đầu và kết thúc đúng mốc vẫn có thể lệch miệng nhân vật.
Có thể dùng RevidAPI và n8n để tự động hóa không?
Bạn có thể dùng n8n để điều phối dữ liệu từng câu và gọi API qua HTTP Request, nhưng cần xác nhận endpoint tạo giọng trước khi cấu hình RevidAPI. Danh sách endpoint
được cung cấp chưa có API TTS để minh họa lời gọi đã xác thực. Bắt đầu với một đoạn video ngắn, kiểm tra từng câu, rồi mở rộng workflow khi bản lồng tiếng đạt yêu cầu.
Khám phá workflow miễn phí tại AI Tạo ảnh & Video và lấy API key tại API Marketplace RevidAPI.
Khám phá API Marketplace RevidAPI — lấy API key miễn phí · Nhóm Zalo hỗ trợ · revidapi@gmail.com