


Chỉnh sửa SRT là sửa nội dung và timestamp để phụ đề khớp lời thoại, từ đó giúp quy trình lồng tiếng AI xử lý chính xác hơn. Bài này hướng dẫn bạn kiểm tra một file `.srt` trước khi đưa vào quy trình lồng tiếng: đọc đúng số thứ tự, rà câu thoại, đối chiếu mốc như `00:00:01,000 --> 00:00:03,500` và chọn cách sửa phù hợp với số lượng file. Bạn cũng sẽ biết nên kiểm tra bản xuất mới trên video thay vì chỉ mở văn bản, vì một câu đúng chữ vẫn có thể xuất hiện lệch nhịp. Một lỗi nhỏ trong dấu câu, tên riêng hoặc thời điểm kết thúc có thể làm giọng đọc ngắt sai câu. Với video dài, việc sửa trực tiếp trên từng dòng còn dễ tạo lỗi dây chuyền: một timestamp bị nhập sai định dạng có thể khiến phần mềm không đọc được các đoạn sau. Vì vậy, hãy giữ bản gốc và chỉ ghi đè sau khi đã xem lại file kết quả.
Tóm tắt nhanh
- SRT gồm số thứ tự, timestamp và lời thoại; timestamp hợp lệ thường dùng dạng `giờ:phút:giây,mili-giây`.
- Trước khi lồng tiếng, kiểm tra cả lỗi chữ lẫn khoảng hiển thị của từng caption trên video.
- Giữ file gốc, lưu bản đã sửa riêng và kiểm tra encoding UTF-8 nếu tiếng Việt bị lỗi dấu.
Chỉnh sửa SRT là gì và khác biên tập phụ đề thông thường ra sao?
Một file SRT không chỉ là phần chữ đặt dưới video. Mỗi caption thường gồm ba thành phần: số thứ tự, khoảng thời gian hiển thị và dòng thoại; giữa các caption có một dòng trống. Ví dụ:
12
00:01:04,500 --> 00:01:07,200
Mời bạn kiểm tra đơn hàng.
Ở đây, `12` là chỉ số của caption, `00:01:04,500` là thời điểm bắt đầu, còn `00:01:07,200` là thời điểm kết thúc. Dấu `-->`, dấu phẩy giữa giây và mili-giây, cùng dòng trống sau lời thoại đều có ý nghĩa khi phần mềm đọc file.
Hai loại sửa thường bị gọi chung là “chỉnh SRT” Sửa nội dung là thay phần chữ nhưng giữ nguyên khoảng thời gian, chẳng hạn đổi “kiểm tra đơn hang” thành “kiểm tra đơn hàng”. Căn chỉnh thời gian lại tác động vào hai mốc `00:01:04,500` và `00:01:07,200`, khi lời nói bắt đầu muộn hơn hoặc kết thúc sớm hơn. Một file có thể cần cả hai: sửa tên thương hiệu “Vina Phon” thành “VinaPhone”, rồi dời thời điểm xuất hiện từ giây 64,500 sang 65,000. Biên tập phụ đề thông thường thường ưu tiên câu dễ đọc trên màn hình, còn chỉnh SRT trước khi lồng tiếng phải coi mỗi caption như dữ liệu đầu vào cho quy trình âm thanh. Nếu một câu bị chia sai tại “không / thể”, hệ thống lồng tiếng có thể nhận hai đoạn rời; nếu timestamp kết thúc ở `00:01:07,200` nhưng câu còn kéo đến giây 8, phần đọc và hình ảnh
sẽ lệch nhau. SRT cũng là cầu nối giữa bản dịch, giọng đọc và timeline dựng video, nên lỗi ở một dòng có thể lan sang bước xử lý kế tiếp.
Thế nào là file hợp lệ trước khi xử lý?
File nên giữ số thứ tự theo từng block, timestamp đúng dạng `HH:MM:SS,mmm`, thời điểm bắt đầu nhỏ hơn thời điểm kết thúc, và lời thoại nằm ngay dưới dòng thời gian. Ví dụ, `00:02:10,000 --> 00:02:09,900` là khoảng thời gian ngược, còn thiếu dòng trống giữa block 3 và block 4 có thể khiến một số công cụ đọc sai. Hãy giữ encoding UTF-8 để chữ tiếng Việt như “hướng dẫn” không biến thành ký tự lỗi trước khi đưa vào lồng tiếng hoặc dựng video.
Những khả năng chính khi chỉnh sửa một file SRT
Một file SRT có thể được sửa ở cả phần chữ lẫn mốc thời gian trước khi đưa vào quy trình lồng tiếng AI. Chẳng hạn, câu “Sản phẩn mới đã ra mắt” cần được sửa thành “Sản phẩm mới đã ra mắt”, còn đoạn `00:00:12,500 --> 00:00:15,000` phải khớp với lúc người nói bắt đầu và kết thúc câu.
Sửa lỗi chữ, dấu câu và tên riêng Bạn có thể sửa lỗi chính tả, thêm dấu phẩy hoặc viết hoa tên thương hiệu mà không thay đổi số thứ tự caption. Ví dụ, “vinfast” có thể đổi thành “VinFast”, “xin chao moi nguoi” thành “Xin chào mọi người.” Với nội dung chuẩn bị cho AI voice, cách viết tên riêng như “Nguyễn Huệ” hoặc thuật ngữ “API” cần
được giữ thống nhất ở tất cả caption.
Gộp hoặc tách caption theo nhịp nói Một caption chứa hai ý dài 18 từ có thể khiến người xem phải đọc quá nhanh. Bạn có thể tách đoạn `00:01:04,000 --> 00:01:08,000` thành hai caption tại điểm ngắt câu, ví dụ sau dấu chấm phẩy; ngược lại, hai caption chỉ có “Đúng vậy,” và “chúng ta bắt đầu” nên
được gộp nếu cùng một nhịp nói và không tạo khoảng trống khó chịu.
Điều chỉnh thời điểm bắt đầu và kết thúc Khi phụ đề xuất hiện trước lời thoại 700 mili giây, hãy dời mốc bắt đầu từ `00:02:10,100` sang `00:02:10,800` nếu đó là lúc âm thanh thực sự bắt đầu. Mốc kết thúc cũng cần bám vào câu nói; không nên để caption kéo dài đến `00:02:15,000` nếu người nói đã dừng ở `00:02:13,600`.
Chuẩn hóa timestamp giữa các phần mềm SRT thường dùng dạng `HH:MM:SS,mmm`, chẳng hạn `00:03:07,250 --> 00:03:09,900`. Nếu công cụ khác xuất timestamp bằng dấu chấm như `00:03:07.250`, bạn cần đổi về dấu phẩy trước khi lưu file SRT; đồng thời kiểm tra đủ ba chữ số phần mili giây để tránh lỗi khi nhập lại.
Giữ thứ tự caption
sau khi biên tập Sau khi sửa nội dung hoặc thời gian, caption số 12 vẫn phải đứng trước caption số 13, và mốc bắt đầu của số 12 không được muộn hơn số 13 nếu hai đoạn liên tiếp. Khi gộp số 12 và 13, hãy xóa một khối trùng, đánh lại số từ đoạn kế tiếp và mở lại file để kiểm tra chuỗi `1, 2, 3…` không bị nhảy số.
Chọn cách chỉnh sửa SRT: thủ công, phần mềm hay AI?
Với một file SRT dài 2 phút và chỉ có vài lỗi gõ sai, mở trực tiếp bằng trình soạn thảo văn bản thường nhanh hơn dựng cả quy trình tự động. Khi bạn có hàng chục file, câu thoại lặp lại hoặc cần xử lý theo cùng một quy tắc, phần mềm phụ đề hay AI sẽ phù hợp hơn.
Chọn công cụ theo loại việc
- Mở file bằng trình soạn thảo văn bản khi cần sửa ít dòng và phải nhìn rõ nội dung thô. Cách này hợp với việc đổi “Tik Tok” thành “TikTok”, sửa tên nhân vật ở 3 caption hoặc bỏ một từ lặp; bạn không cần thêm phần mềm chỉ để chỉnh vài ký tự.
- Dùng phần mềm phụ đề khi cần xem chữ cùng hình ảnh và âm thanh. Với một video 10 phút có nhiều đoạn phải kéo lại theo khẩu hình, hãy mở file trong trình chỉnh phụ đề, phát từng đoạn và sửa ngay tại vị trí đang nghe thấy lệch. Cách này giảm việc phải đoán timestamp từ những con số trong văn bản.
- Chọn công cụ xử lý tự động khi có nhiều file cùng cấu trúc, chẳng hạn 30 video sản phẩm đều dùng các cụm “đặt hàng”, “miễn phí vận chuyển” và tên mã SKU. Trước khi chạy cả thư mục, lấy 2 file đại diện để kiểm tra quy tắc; AI không nên được quyền ghi đè bản gốc ngay từ lần đầu.
- Đặt số lượng file, độ dài và mức lặp lại lên trước tên công cụ. Một file 90 giây nhưng có 20 tên riêng vẫn cần kiểm duyệt kỹ hơn 10 file dài chứa câu thoại lặp; ngược lại, 50 file có cùng mẫu câu có thể đáng để tự động hóa dù mỗi file chỉ dài 1 phút.
- Phát video sau khi chỉnh, thay vì chỉ đọc SRT từ đầu đến cuối. Kiểm tra ít nhất ba điểm cụ thể: câu có xuất hiện trước khi người nói bắt đầu không, caption có biến mất trước khi câu kết thúc không, và dòng mới có cắt giữa một cụm như “chính sách đổi trả” không. Nếu lỗi chỉ lặp ở cùng một mốc, sửa quy tắc; nếu lỗi nằm ở tên người hoặc thương hiệu, giữ bước duyệt thủ công.
Quy trình kết hợp AI và người duyệt 6. Cho AI xử lý phần lặp lại như lỗi chính tả đã biết hoặc cách viết thống nhất, nhưng khóa các tên riêng bằng danh sách kiểm tra. Người duyệt đọc lại “Nguyễn Huệ”, “Shop Mây” và mã “A12-B” trên video; chỉ
sau khi các mục này đúng mới xuất file SRT mới. Lưu bản gốc, bản AI sửa và bản đã duyệt thành ba file riêng để có thể quay lại khi một câu bị sửa sai.
Giới hạn, chi phí và trường hợp không nên tự động sửa SRT
Tự động sửa SRT không giải quyết được timestamp sai hàng loạt nếu nguyên nhân nằm ở toàn bộ bản ghi âm hoặc video. Ví dụ, mọi caption đều bắt đầu sớm hơn khoảng 2 giây thì bạn nên xác định độ lệch chung trước; nếu mỗi đoạn lệch một mức khác nhau, cần kiểm tra việc cắt video, tốc độ phát hoặc nguồn transcript thay vì cho AI sửa từng dòng.
Khi dữ liệu đầu vào chưa đủ tin cậy File thiếu lời thoại là trường hợp không nên tự động đoán. Một đoạn có timestamp `00:01:12,500 --> 00:01:16,000` nhưng phần text bị bỏ trống không cho hệ thống biết người nói câu gì hay cần kéo dài bao lâu. Tương tự, file bị lỗi mã hóa có thể biến tiếng Việt thành chuỗi như `Ti bfng Vi c7t`; hãy xử lý encoding trước, thường bằng UTF-8, rồi mới đưa vào công cụ chỉnh sửa. Nội dung nhiều thuật ngữ cũng cần người kiểm tra cuối. Tên thuốc, mã sản phẩm, tên API hoặc câu có số liệu như `HTTP 429` dễ bị sửa thành từ quen thuộc nhưng sai nghĩa. Với file dùng để lồng tiếng, hãy mở bản kết quả cạnh video và đối chiếu các tên riêng, con số, timestamp đầu-cuối trước khi ghi đè file gốc.
Chi phí không chỉ nằm ở một lần bấm Công cụ có thể tính phí theo lượt gọi, số token, độ dài file hoặc model
được chọn. Một file SRT dài 60 phút, bị chia thành 20 lần gọi để tránh giới hạn đầu vào, có thể phát sinh 20 lượt tính phí thay vì một lượt; lần chạy lại
sau khi lỗi cũng có thể bị tính thêm. Hãng chưa công bố một mức giá chung cho mọi công cụ, nên bạn cần kiểm tra bảng giá model và giới hạn đầu vào trước khi chạy hàng loạt. Không nên tự động sửa khi bản gốc thiếu nhiều câu, timestamp sai không theo quy luật, hoặc file chứa thuật ngữ mà không có danh sách chuẩn để đối chiếu. Khi đó, sửa thủ công một bản mẫu và xác định quy tắc trước sẽ an toàn hơn việc ghi đè hàng chục file rồi phải phục hồi từ bản sao.
Hai tình huống chỉnh sửa SRT thường gặp tại Việt Nam
Creator sửa video ngắn trước khi lồng tiếng nhiều ngôn ngữ Một creator làm TikTok hoặc YouTube Shorts thường bắt đầu với file SRT tiếng Việt rồi tạo bản đọc tiếng Anh, Thái hoặc Indonesia. Trước khi gửi cho người lồng tiếng, họ cần rút những câu dài thành nhịp ngắn, giữ đúng tên người và bỏ các từ đệm không cần thiết. Ví dụ, câu “Mọi người ơi, hôm nay mình
sẽ chia sẻ với các bạn…” có thể khiến giọng đọc kéo dài hơn cảnh; bản sửa nên giữ phần thông tin chính thay vì bê nguyên khẩu ngữ. Với video dài 30–60 giây, creator nên đối chiếu từng caption với đoạn nhân vật thực sự nói, nhất là khi câu bị cắt giữa hai ý. Tên riêng như “Nguyễn Hà Đông”, tên sản phẩm hoặc địa danh Việt Nam cũng cần được giữ một cách nhất quán giữa các bản ngôn ngữ. Nếu đổi cách viết tên ở một caption nhưng giữ cách cũ ở caption khác, người lồng tiếng và người duyệt âm thanh sẽ phải sửa lại thủ công.
Marketer đồng bộ phụ đề cho quảng cáo và video bán hàng Marketer thường sửa SRT cho video sản phẩm, quảng cáo Facebook hoặc nội dung livestream cắt ngắn. Ưu tiên lúc này không chỉ là câu dễ đọc, mà còn là thuật ngữ thương hiệu, tên mã hàng và thông điệp bắt buộc. Chẳng hạn, “Kem chống nắng SPF 50+” không nên bị đổi thành “kem chống nắng SPF năm mươi cộng” nếu kịch bản thương hiệu đã quy định cách đọc và cách viết riêng. Một caption chứa giá “199.000đ”, mã “S24 Ultra” hoặc lời kêu gọi “Mua ngay” phải xuất hiện đủ lâu để người xem đọc kịp trước khi cảnh chuyển. Marketer có thể đối chiếu SRT với video quảng cáo 15 giây và kiểm tra riêng các đoạn chứa giá, phần trăm giảm giá, mã khuyến mãi và tên gian hàng. Với nội dung bán hàng có nhiều phiên bản, việc đặt tên file theo mẫu như `san-pham-15s-vn.srt` và `san-pham-15s-en.srt` giúp tránh ghi đè nhầm bản. Khi kho nội dung có hàng chục hoặc hàng trăm file, developer có thể viết quy trình đọc từng file, gửi phần cần sửa và lưu thành bản mới thay vì sửa trực tiếp file gốc. Cách này phù hợp với các lỗi lặp lại như tên thương hiệu viết sai, nhưng vẫn cần người kiểm tra những câu chứa giá, tên riêng và thông điệp pháp lý trước khi xuất bản.
Cách chỉnh sửa SRT bằng RevidAPI với endpoint lấy từ Dashboard
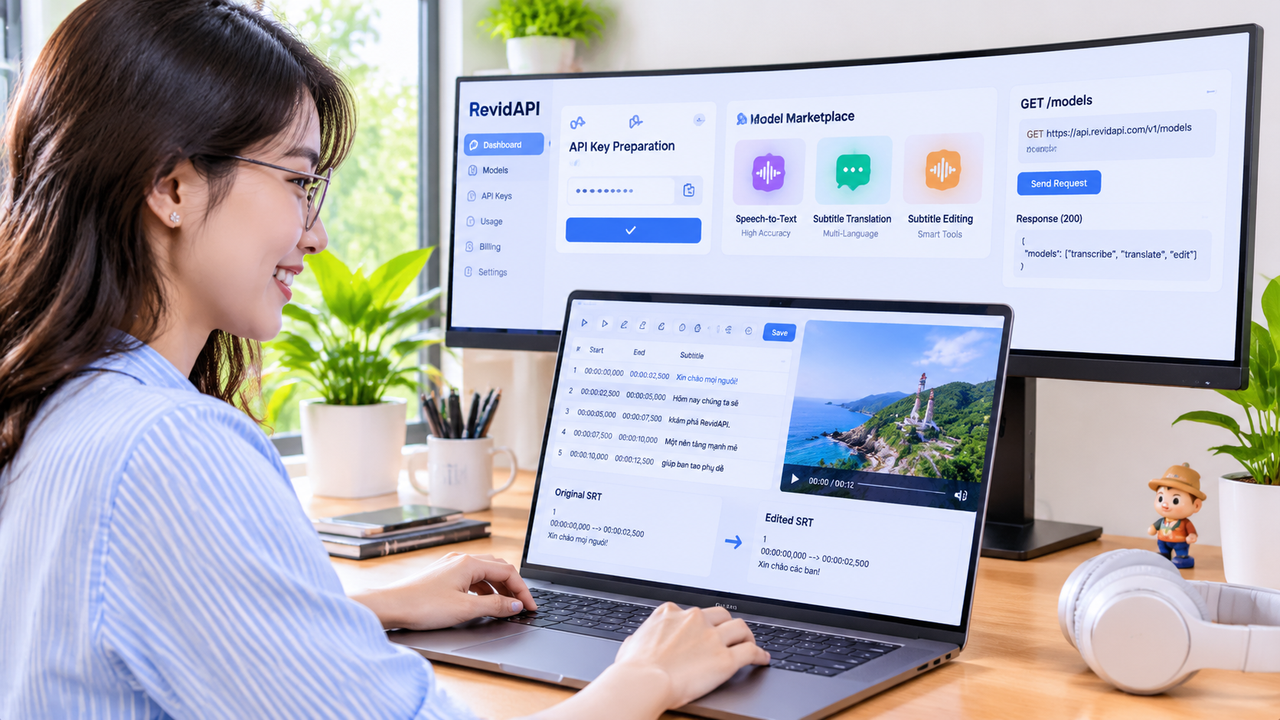
Chuẩn bị key và model Mở RevidAPI Dashboard để tạo hoặc lấy API key, rồi xem danh sách model bằng Marketplace hoặc endpoint `GET https://revidapi.com/v1/chat/models`. Giá credit và model khả dụng cần kiểm tra trực tiếp trên giao diện hoặc phản hồi
của endpoint này; dữ liệu hiện có không xác nhận một mức giá cố định cho xử lý SRT. Với bài toán sửa phụ đề, bạn có thể gửi nội dung SRT tới endpoint tương thích OpenAI `POST https://revidapi.com/v1/chat/completions`. Dùng model đã chọn trong Dashboard, yêu cầu rõ hai việc: sửa lỗi chữ và điều chỉnh timestamp, đồng thời giữ nguyên số thứ tự, định dạng `HH:MM:SS,mmm --> HH:MM:SS,mmm` và các dòng trống của SRT.
Gửi yêu cầu bằng REST API Đặt key vào biến môi trường để không ghi thẳng vào file shell. Mẫu dưới đây dùng endpoint thật; thay `claude-sonnet-5` bằng model
được trả về từ `GET /v1/chat/models` nếu Dashboard hiển thị lựa chọn khác.
export REVIDAPI_KEY="YOUR_API_KEY"
export SRT_TEXT="$(cat input.srt)" curl -X POST "https://revidapi.com/v1/chat/completions" \ -H "Authorization: Bearer $REVIDAPI_KEY" \ -H "Content-Type: application/json" \ -d "$(jq -n --arg srt "$SRT_TEXT" '{model:"claude-sonnet-5",messages:[{role:"user",content:("Sửa lỗi chính tả và timestamp trong SRT dưới đây. Giữ nguyên định dạng SRT, số thứ tự và nội dung không cần sửa. Chỉ trả về SRT, không thêm giải thích:\n\n" + $srt)}]}')" \ > response.json
`response.json` là phản hồi cần kiểm tra trước khi ghi đè `input.srt`. Vì cấu trúc trường trả về phải đối chiếu theo tài liệu model trong Dashboard, hãy xác nhận nội dung chỉ còn các block SRT, có mũi tên `-->`, timestamp hợp lệ và thứ tự không bị đảo; sau đó lưu thành `output.srt` rồi mở cùng video để đối chiếu điểm bắt đầu và kết thúc.
Nối vào quy trình tự động Nếu có nhiều file, bạn có thể đưa lệnh gọi này vào RevidAPI n8n, nhưng vẫn nên giữ bước phê duyệt trước khi thay file gốc. Một yêu cầu chứa SRT dài cũng cần
được kiểm tra giới hạn model và credit ngay trên Dashboard; hãng chưa công bố trong dữ liệu hiện có một giới hạn riêng cho số dòng SRT.
Câu hỏi thường gặp về chỉnh sửa SRT
Chỉnh sửa SRT có làm thay đổi nội dung lời thoại không?
Không nhất thiết. Bạn có thể chỉ sửa timestamp như `00:01:12,500 --> 00:01:15,000`, chỉ sửa chữ, hoặc làm cả hai. Nếu mục tiêu là giữ nguyên lời thoại để lồng tiếng, hãy ghi rõ yêu cầu “giữ nguyên nội dung, chỉ chỉnh thời gian”; ngược lại, lỗi chính tả, tên riêng hoặc dấu câu cần
được sửa trong phần văn bản.
Có thể chỉnh timestamp tự động từ file SRT không?
Có, nhưng file cần có lời thoại đủ rõ và timestamp ban đầu không hỏng toàn bộ. Chẳng hạn, công cụ có thể dựa vào câu “Xin chào, cảm ơn bạn đã theo dõi” để căn lại thời điểm, nhưng khó xác định vị trí nếu nhiều đoạn bị trống hoặc toàn bộ mốc thời gian đều là `00:00:00,000`. Sau khi chạy tự động, hãy đối chiếu với âm thanh thay vì ghi đè file gốc ngay.
Nên dùng SRT hay định dạng khác khi lồng tiếng AI?
SRT thường phù hợp khi bạn cần chỉnh trực tiếp số thứ tự, nội dung và timestamp bằng trình soạn thảo văn bản. Định dạng khác có thể giữ thêm kiểu chữ hoặc vị trí hiển thị, nhưng mức tương thích tùy công cụ video và nền tảng lồng tiếng. Với quy trình chỉ cần lời thoại cùng mốc thời gian, SRT là lựa chọn dễ trao đổi và dễ sửa hơn.
Làm sao kiểm tra SRT
sau khi chỉnh sửa? Hãy xem toàn bộ video một lần, rồi kiểm tra riêng ba vùng: đoạn đầu, đoạn giữa và đoạn cuối. Tạm dừng ở các câu dài để xem chữ có xuất hiện đủ hay bị cắt trước khi người nói kết thúc; đồng thời kiểm tra một mốc cụ thể như `00:05:10,000` có khớp âm thanh hay không. Nếu dùng phần mềm dựng video, hãy thử mở lại file sau khi lưu để phát hiện lỗi mã hóa hoặc timestamp sai định dạng.
RevidAPI có endpoint cố định cho mọi model không?
Không nên giả định như vậy. Với Chat/LLM, endpoint hiện có là `POST https://revidapi.com/v1/chat/completions`, nhưng model và giá cần xem từ `GET https://revidapi.com/v1/chat/models`; loại tương thích Anthropic dùng `POST https://revidapi.com/v1/messages`. Hãy lấy API key tại Dashboard RevidAPI và đọc endpoint
của model đang chọn trong tài liệu trước khi tích hợp.
Khám phá workflow miễn phí tại AI Tạo ảnh & Video và lấy API key tại API Marketplace RevidAPI.
Khám phá API Marketplace RevidAPI — lấy API key miễn phí · Nhóm Zalo hỗ trợ · revidapi@gmail.com