


Chưa có đủ bằng chứng chính thức trong nguồn được cung cấp để kết luận Claude Opus 5.5 hay Claude Fable 5.1 viết dài tốt hơn. Nếu bạn đang chọn model để viết tài liệu sản phẩm nhiều chương, một bảng điểm benchmark chưa trả lời được bản thảo nào sẽ dùng được sau biên tập. Bài này giúp bạn kiểm tra hai tên model, xác định tiêu chí viết dài và chuẩn bị phép thử cùng brief trước khi chọn. Chẳng hạn, khi giao viết hướng dẫn sử dụng cho khách hàng Việt Nam, bạn cần bằng chứng từ bản thảo đúng yêu cầu đó; các đoạn trích hiện có chưa cung cấp phép thử tương ứng.
Tóm tắt nhanh
- Chưa thể chọn bên thắng: nguồn cung cấp chưa đủ xác nhận chính thức hai tên Claude Opus 5.5 và Claude Fable 5.1, cũng chưa đủ để kết luận về viết dài.
- Đọc benchmark đúng phạm vi: đoạn trích BenchLM tập trung vào coding; đoạn trích ExplainX chưa có phép thử viết dài tiếng Việt.
- Bước tiếp theo: xác minh model trước, rồi thử cùng brief và tài liệu nguồn; kết quả chưa đo phải được ghi rõ là chưa đo.
Claude Opus 5.5 và Claude Fable 5.1 là gì?
Nguồn được cung cấp chưa đủ để xác nhận chính thức hai tên Claude Opus 5.5 và Claude Fable 5.1. Chúng xuất hiện trong kết quả SERP, nhưng chưa có tài liệu nhà cung cấp đi kèm để đối chiếu danh tính và phiên bản. Vì vậy, bạn nên coi đây là hai tên đang cần kiểm chứng trước khi dùng chúng làm căn cứ chọn model viết dài. Có ba lớp thông tin cần tách riêng: tên mô hình, phiên bản và nền tảng phân phối. Với chuỗi “Claude Opus 5.5”, phần “5.5” trông như số phiên bản, nhưng cách đặt tên tự nó chưa xác nhận một bản phát hành. Tương tự, tên “Claude Fable 5.1” trên trang so sánh chưa đủ chứng minh đây là tên do nhà cung cấp công bố. Nền tảng phân phối là nơi bạn truy cập mô hình; nhãn hiển thị và định danh dùng để gọi mô hình có thể khác nhau. Chẳng hạn, nếu giao diện ghi “Fable 5.1”, bạn vẫn cần biết giá trị thực tế của trường `model` và tài liệu giải thích nó trỏ tới phiên bản nào. Chỉ nhìn nhãn trên giao diện thì chưa xác định được điều đó. Trong nguồn hiện có, LLM Stats chủ yếu cung cấp metadata và schema so sánh. Nội dung crawl của OrcaRouter lại chủ yếu là thông báo JavaScript và CSS. Cả hai chưa cung cấp căn cứ để xác nhận tên chính thức; đoạn trích ExplainX cũng chưa bổ sung được phép thử viết dài tiếng Việt. Trước khi ghi thông số cho Opus 5.5 hoặc Fable 5.1, bạn cần đối chiếu trang model hoặc thông báo phát hành của nhà cung cấp, rồi kiểm tra định danh tương ứng trên nền tảng sử dụng. Nếu chưa nối được các thông tin này, hãy giữ trạng thái “Chưa xác minh”. Nguồn hiện tại chưa đủ để kết luận bên nào viết dài tốt hơn; việc đó còn cần phép thử cùng brief.
Viết dài cần những năng lực cốt lõi nào?
Một bài đủ dung lượng vẫn có thể sai brief: bạn yêu cầu hướng dẫn cho chủ shop, nhưng bản thảo lại giải thích kiến trúc phần mềm cho developer. Khi đánh giá viết dài, cần nhìn cả khả năng giữ yêu cầu từ mở bài đến kết luận.
Bám brief và giữ cấu trúc Bám brief là giữ đúng mục tiêu, người đọc, dung lượng và định dạng cùng lúc. Ví dụ, bài hướng dẫn chọn phần mềm quản lý kho phải giúp chủ shop ra quyết định; một đoạn phân tích database dù đúng vẫn có thể lệch yêu cầu. Cấu trúc thể hiện ở cách phân bổ nội dung. Nếu dàn ý yêu cầu phân tích chi phí nhưng bản thảo chỉ dành một câu cho mục này, bài chưa đạt dù có đủ tiêu đề. Chuyển đoạn cũng cần nối
được lập luận, chẳng hạn từ vấn đề lệch tồn kho sang tiêu chí kiểm tra tính năng đồng bộ.
Nhất quán và có căn cứ Nhất quán bao gồm thuật ngữ, giọng văn và chi tiết. Nếu đầu bài dùng “doanh thu” thì cuối bài không
được đổi thành “lợi nhuận” cho cùng một số liệu. Một giả định như “shop chưa có nhân viên kho” cũng phải được giữ khi đề xuất quy trình. Độ tin cậy đòi hỏi tách dữ kiện có nguồn khỏi suy luận. Với thông tin “phần mềm hỗ trợ xuất CSV”, bản thảo có thể nêu công dụng chuyển dữ liệu; chưa thể suy ra phần mềm đồng bộ thời gian thực. Chỗ nguồn không xác nhận phải được ghi rõ, thay vì bổ sung bằng phỏng đoán.
Tiếng Việt và giới hạn đầu ra Tiếng Việt cần đúng sắc thái và rõ nghĩa. Câu “thực hiện việc tiến hành đối soát” nên rút thành “đối soát”. Cách xưng hô “bạn” cũng cần nhất quán, tránh bất chợt chuyển sang “quý doanh nghiệp” trong bài dành cho chủ shop nhỏ. Context window là sức chứa ngữ cảnh
của một lượt xử lý, không phải độ dài đầu ra được bảo đảm. Tài liệu nguồn, lịch sử hội thoại và nội dung sinh ra đều chịu các giới hạn liên quan. Token không tương đương từ tiếng Việt; cửa sổ lớn không bảo đảm trả đủ bài trong một lượt. Với hai tên model đang xét, nguồn cung cấp chưa đủ để kết luận bên nào viết dài tốt hơn; cần thử cùng brief.
So sánh Claude Opus 5.5 vs Fable 5.1 cho viết dài như thế nào?
Bạn cần giữ nguyên đề bài giữa hai lượt chạy để biết khác biệt đến từ đâu. Với nguồn được cung cấp, chưa đủ bằng chứng chính thức để kết luận Claude Opus 5.5 hay Claude Fable 5.1 viết dài tốt hơn; bảng bên dưới là mẫu ghi nhận, chưa phải kết quả thử nghiệm.
Thiết lập phép thử có thể đối chiếu
- Lưu một bộ đầu vào dùng chung. Tạo tệp brief gồm đối tượng đọc, mục tiêu bài, dàn ý, tài liệu nguồn và quy tắc thuật ngữ. Chẳng hạn, yêu cầu bài hướng dẫn chọn phần mềm quản lý kho dài 1.800–2.000 từ, giữ nguyên các mục đã giao. Đây là đề thử đề xuất, không phải phép đo đã thực hiện.
- Chạy và lưu nguyên bản nháp. Gửi cùng nội dung đầu vào, giữ bản xuất trước khi sửa và ghi thời điểm bắt đầu, kết thúc. Lưu tên model hiển thị, mã phiên bản nếu có và cấu hình từng lượt. Nếu một bên dừng giữa bài, ghi “bản nháp chưa hoàn tất”; lưu riêng lượt yêu cầu viết tiếp.
- Ẩn tên model rồi chấm từng nhóm lỗi. Đặt tên bản A và B. Dùng thang đề xuất 0–2 cho từng mục dàn ý: thiếu, có nhưng sai yêu cầu, đạt yêu cầu. Ghi riêng lỗi cấu trúc, thuật ngữ, câu tiếng Việt cần viết lại và khẳng định không có nguồn hỗ trợ. Mỗi lỗi phải kèm vị trí hoặc trích đoạn để người khác kiểm tra được.
- Sửa về cùng điều kiện nghiệm thu. Ví dụ: đủ mục, đúng khoảng độ dài và xử lý hết khẳng định thiếu nguồn. Ghi số vòng yêu cầu sửa, số phút biên tập thủ công và lượng dùng được nền tảng báo cáo. Giữ điểm bản nháp riêng với công sửa bài; chưa có bảng giá và lượng dùng thì chưa điền chi phí.
Bảng ghi nhận bằng chứng
| Tiêu chí | Claude Opus 5.5 | Claude Fable 5.1 | Bằng chứng cần có |
|---|---|---|---|
| Bám dàn ý | Chưa đo | Chưa đo | Cùng brief và quy tắc chấm |
| Nhất quán thuật ngữ | Chưa đo | Chưa đo | Đánh giá mù |
| Tiếng Việt | Chưa đo | Chưa đo | Người chấm tiếng Việt |
| Nguồn dẫn | Chưa xác minh | Chưa xác minh | Nguồn chính thức và bản xuất |
| Sửa bài | Chưa đo | Chưa đo | Số vòng chỉnh sửa |
| Thời gian | Chưa đo | Chưa đo | Ghi thời gian thực tế |
| Chi phí | Chưa xác minh | Chưa xác minh | Bảng giá và lượng dùng |
Những hạn chế dễ bị bỏ qua khi so sánh mô hình
Điểm coding trên BenchLM không cho biết mô hình có giữ được lập luận xuyên suốt một bài tiếng Việt hay không. Đoạn trích được cung cấp còn tự ghi mức độ tin cậy hạn chế. ExplainX đề cập benchmark và giá, nhưng đoạn trích chưa có phép thử viết dài tiếng Việt để suy ra bên thắng.
Nguồn chưa đủ để chốt lựa chọn Bản crawl OrcaRouter chủ yếu chứa thông báo JavaScript và CSS; schema
của LLM Stats cũng không xác nhận tên hay phiên bản chính thức. Với bộ nguồn này, chưa đủ bằng chứng chính thức để kết luận Claude Opus 5.5 hay Claude Fable 5.1 viết dài tốt hơn. Bạn chưa nên dựa vào các trang đó để quyết định chuyển toàn bộ quy trình viết.
Sai lệch có thể nằm ngoài mô hình Nếu prompt bên A có bài mẫu còn bên B chỉ nhận yêu cầu “viết chuyên sâu”, kết quả phản ánh cả phần hướng dẫn bổ sung. Tương tự, giới hạn đầu ra thấp có thể khiến bài kết thúc sớm; tài liệu nguồn thiếu trang có thể làm mất luận cứ. Chưa thể quy những lỗi ấy cho năng lực viết. Người chấm cũng tạo sai lệch: biên tập viên thích câu ngắn có thể chê bản nhiều câu ghép dù nội dung đúng. Một nhận xét như “giọng văn tốt hơn” cần nêu rõ đoạn nào và yêu cầu biên tập nào bị vi phạm.
Giá lượt gọi chưa phải giá bài hoàn chỉnh Một bản nháp phải tạo lại, sửa trích dẫn rồi nối đoạn bị cụt
sẽ phát sinh thêm công. Brief chưa có giá đã xác minh cho hai tên model; vì vậy chưa thể kết luận bên nào rẻ hơn trên mỗi bài được duyệt.
Ứng dụng tại Việt Nam: mini case bài chuyên sâu 2.200 từ
Một agency nhận bài 2.200 từ cho shop nội thất có thể mất nhiều công sửa chỉ vì bản nháp nhầm “gỗ công nghiệp” thành “gỗ tự nhiên”. Hai tình huống sau là đề xuất thử nghiệm tại Việt Nam, chưa phải case study đã có kết quả. Nguồn được cung cấp chưa đủ để kết luận Claude Opus 5.5 hay Claude Fable 5.1 viết dài tốt hơn.
Agency viết bài tư vấn cho shop nội thất Bạn phụ trách bài “Chọn bàn ăn cho căn hộ nhỏ”, dành cho người mua ở TP.HCM. Gói đầu vào gồm danh mục sản phẩm, kích thước, vật liệu và chính sách giao hàng do shop xác nhận. Cả hai bản thảo dùng chung dàn ý và quy ước giữ nguyên tên vật liệu trong danh mục. Brief chia 2.200 từ thành: mở bài 150 từ, đo không gian 450 từ, chọn vật liệu 600 từ, bố trí bàn ghế 600 từ và lưu ý mua hàng 400 từ. Người biên tập nhận hai bản mang nhãn A/B, không thấy tên model. Họ đánh dấu từng chỗ sai kích thước, tự thêm chính sách bảo hành hoặc lặp lời khuyên “đo diện tích trước khi mua” mà không bổ sung thông tin.
Creator viết hướng dẫn cho chủ shop online Bạn làm bài 2.200 từ về cách đọc báo cáo thu–chi cho người bán hàng trên sàn. Hai model nhận cùng tài liệu đối soát đã ẩn thông tin khách hàng và cùng quy chuẩn phân biệt “doanh thu”, “tiền thực nhận”, “lợi nhuận”. Dàn ý yêu cầu giải thích riêng phí sàn, hoàn hàng và khoản chờ thanh toán. Khi chấm mù, người sửa đối chiếu từng ví dụ với tài liệu. Một đoạn đồng nhất tiền thực nhận với lợi nhuận phải
được ghi là lỗi nội dung; đoạn đưa hướng dẫn hoàn hàng sang mục phí sàn được ghi là lệch dàn ý. Bạn bấm giờ từ lúc mở bản nháp đến khi hoàn tất kiểm chứng và sửa bài.
Chỉ chốt lựa chọn
sau khi sửa xong Với mỗi tình huống, lưu bản gốc, bản đã sửa và phiếu ghi số lỗi nguồn, đoạn lặp ý, mục lệch dàn ý, số phút biên tập cho A/B. Hiện các ô kết quả đều là “Chưa đo”. Chỉ mở nhãn model sau khi chấm xong; kết luận khi đó cũng chỉ áp dụng cho brief 2.200 từ đã thử.
Mẹo viết dài và hướng tích hợp RevidAPI
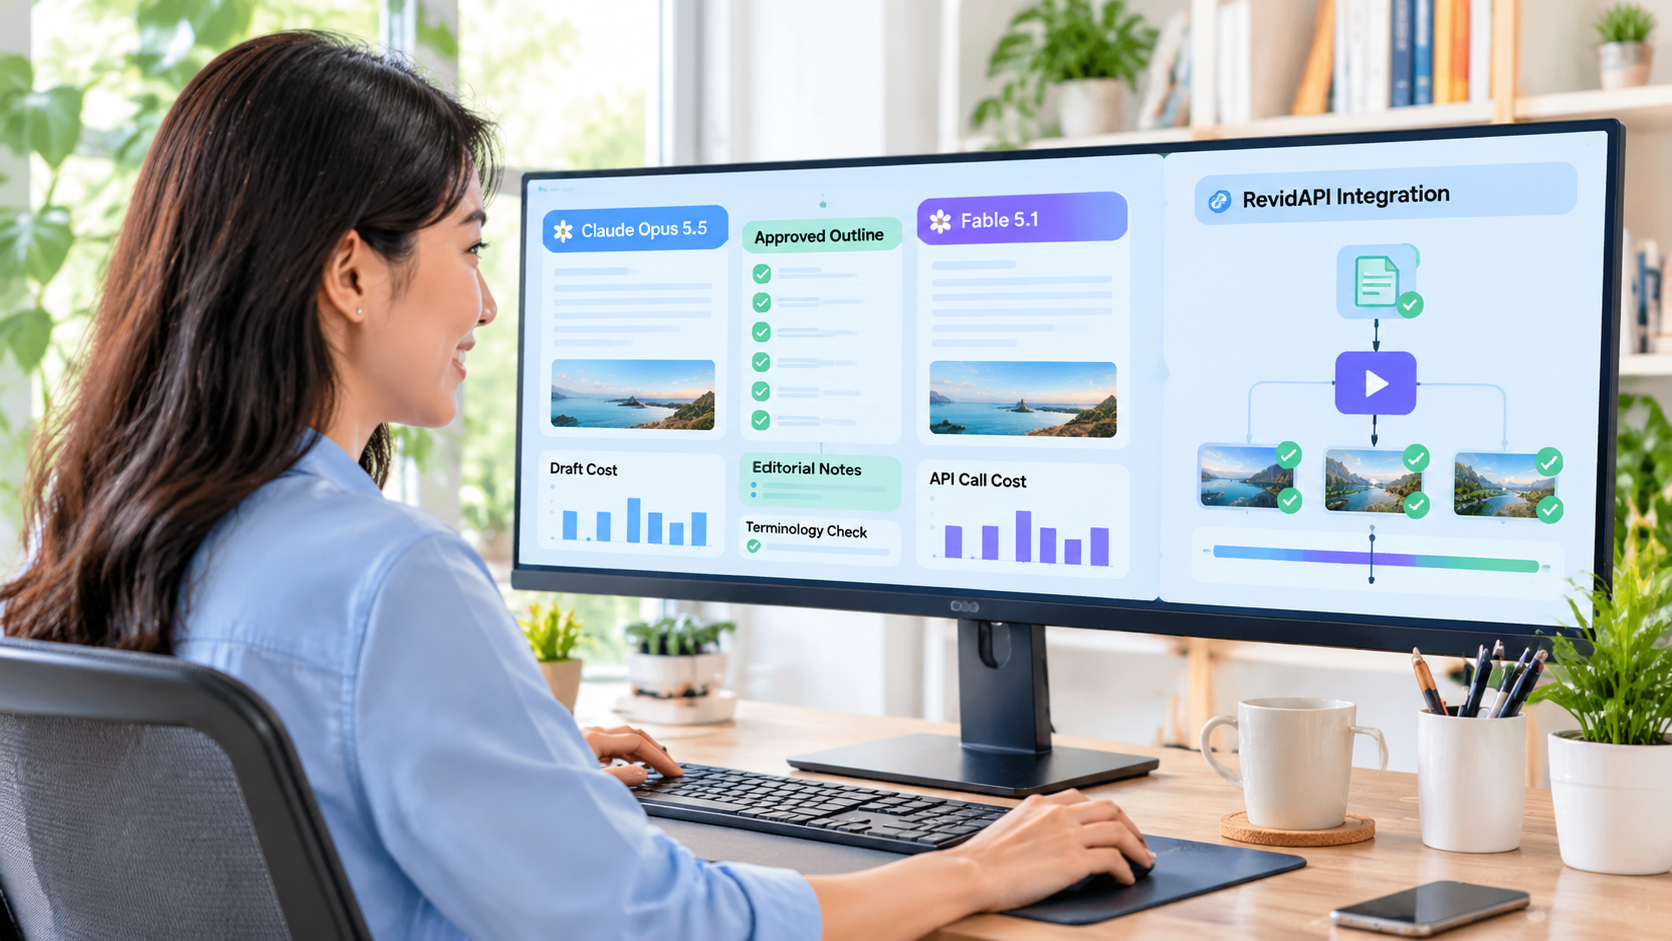
Khi viết từng phần, bạn nên gửi kèm một bản ghi biên tập đã cập nhật. Ví dụ, phần triển khai không được tự đổi thuật ngữ “chi phí mỗi bản thảo” thành “giá mỗi lượt gọi”: hai cách tính này khác nhau.
Giữ mạch giữa các lượt viết Chốt dàn ý trước khi gọi API. Với mỗi phần, ghi rõ luận điểm, giới hạn dung lượng và ý không
được nhắc lại; chẳng hạn: “Viết 300–400 từ về triển khai, không giải thích lại tiêu chí chấm”. Đây là yêu cầu biên tập, không phải bảo đảm đầu ra
sẽ đúng số từ. Sau mỗi phần được duyệt, cập nhật bản ghi gồm sự kiện có nguồn, thuật ngữ thống nhất và quyết định biên tập. Ví dụ: “Chưa có phép thử viết dài tiếng Việt; giữ cách ghi ‘chưa đo’; không suy ra chất lượng viết từ benchmark coding”. Gửi bản ghi này cùng brief ở lượt tiếp theo. Khi ghép bài, yêu cầu rà soát toàn văn và trả về vị trí lỗi: “Chỉ ra hai đoạn lặp luận điểm, thuật ngữ bị đổi và câu mâu thuẫn; đề xuất sửa từng chỗ”. Bạn duyệt danh sách trước khi cho viết lại.
Kiểm tra model rồi mới tích hợp Trên RevidAPI, lấy API key tại Dashboard và gọi `GET https://revidapi.com/v1/chat/models` để đối chiếu model ID cùng giá theo token. Nguồn
được cung cấp chưa xác nhận ID
của Claude Opus 5.5 hoặc Claude Fable 5.1 trên nền tảng; vì vậy chưa thể dùng mã mẫu để kết luận bên nào viết dài tốt hơn. Endpoint chat theo brief dùng schema tương thích OpenAI. Ví dụ kiểm tra kết nối:
curl https://revidapi.com/v1/chat/completions \ -H "x-api-key: YOUR_API_KEY" \ -H "Content-Type: application/json" \ -d '{"model":"claude-sonnet-5","messages":[{"role":"user","content":"Lập dàn ý bài hướng dẫn quản lý tồn kho cho shop quần áo."}]}'`claude-sonnet-5` chỉ minh họa kết nối. Khi hai model cần so sánh có ID được xác nhận, giữ nguyên `messages`, brief và các tham số chung được hỗ trợ, chỉ thay `model`. Kiểm tra schema trong tài liệu hiện hành trước khi thêm tham số; đối chiếu bảng giá và lịch sử credit trong Dashboard để ghi chi phí chạy thực tế.
FAQ về Claude Opus 5.5 vs Fable 5.1 và bước tiếp theo
Claude Opus 5.5 và Claude Fable 5.1 đã
được xác minh chính thức chưa? Nguồn được cung cấp chưa đủ để xác minh chính thức hai tên mô hình này. Metadata trên LLM Stats và nội dung crawl OrcaRouter chưa đủ làm căn cứ; bạn cần đối chiếu tên, phiên bản với tài liệu nhà cung cấp trước khi chọn model.
Claude Opus 5.5 hay Fable 5.1 viết dài tốt hơn?
Chưa thể kết luận khi thiếu thử nghiệm cùng brief và dữ liệu kiểm chứng. Với bài tiếng Việt 2.200 từ trong tình huống minh họa, hiện chưa có hai bản thảo
được chấm để xác định bên phù hợp hơn.
Benchmark coding có phản ánh chất lượng viết dài không?
Không đủ. Đoạn trích BenchLM tập trung vào coding; đoạn trích ExplainX chưa cung cấp phép thử viết dài tiếng Việt, nên bạn vẫn cần đánh giá cấu trúc, tính nhất quán, độ chính xác và cách dùng tiếng Việt.
Nên so sánh chi phí viết dài bằng tiêu chí nào? Bạn cần cộng phí sử dụng
của các lượt tạo, kể cả lượt tạo lại, rồi tính thêm công biên tập. Chẳng hạn, hãy ghi riêng phí API, số lần viết lại phần mở bài và số phút sửa bản thảo; nguồn hiện có chưa đủ để chốt giá cho hai model.
Có thể gọi hai mô hình này qua RevidAPI không? Chưa thể xác nhận từ dữ liệu
được cung cấp. Bạn có thể kiểm tra `GET /v1/chat/models` và tài liệu hiện hành để đối chiếu model ID, giá và khả năng truy cập trước khi thiết lập phép thử.
Khám phá workflow miễn phí tại AI Tạo ảnh & Video và lấy API key tại API Marketplace RevidAPI.
Khám phá API Marketplace RevidAPI — lấy API key miễn phí · Nhóm Zalo hỗ trợ · revidapi@gmail.com