


Model nhẹ thường là lựa chọn rẻ để phân loại tin đơn giản, nhưng bạn vẫn cần kiểm thử dữ liệu tiếng Việt và chuyển tin khó cho người duyệt. Bài viết này giúp bạn đặt tiêu chí chọn model, ước tính chi phí theo token, dựng luồng gắn nhãn cho các nhóm như hỏi giá, chốt đơn, khiếu nại và vận chuyển, rồi xác định lúc nào không nên để máy tự quyết. Một thử nghiệm được SERP mô tả dùng 50 tin mẫu: 40 tin thường được phân loại đúng, còn tin nhiều ý cần bổ sung nhãn phụ. Con số này chỉ mang tính tham khảo vì nguồn có độ tin cậy trung bình và chưa đại diện cho dữ liệu của shop bạn. Chi phí khoảng 0,2 USD cho 1.000 tin được một bài thử nghiệm ước tính theo bảng giá trả phí, nhưng đây là claim độ tin cậy thấp. Tin dài hơn, prompt dài hơn hoặc yêu cầu đầu ra nhiều trường sẽ làm tăng token đầu vào và đầu ra, nên “rẻ nhất” không đồng nghĩa với chi phí thực tế thấp nhất.
Tóm tắt nhanh
- Bắt đầu bằng model nhẹ cho tin một mục đích, chẳng hạn “giá áo này bao nhiêu”.
- Dùng tập kiểm thử tiếng Việt gồm tin không dấu, viết tắt và tin vừa hỏi giá vừa hỏi phí ship.
- Đặt nhánh người duyệt cho tin mơ hồ thay vì ép mọi tin vào một nhãn duy nhất.
Phân loại tin nhắn khách hàng bằng AI là gì?
Một shop nhận vài trăm tin mỗi ngày từ fanpage, website và sàn thương mại điện tử sẽ nhanh chóng gặp các đoạn như “giá bao nhiêu”, “đơn của em tới đâu rồi” hoặc “hàng lỗi đổi thế nào”. Phân loại tin nhắn bằng AI là việc đọc nội dung đó rồi gắn vào nhãn theo ý định, nhu cầu hoặc trạng thái xử lý, chẳng hạn `hoi_gia`, `van_chuyen` và `khieu_nai`. AI ở bước này không nhất thiết phải trả lời khách. Bạn có thể chỉ yêu cầu hệ thống nhận một tin, trả về nhãn `chot_don`, rồi đẩy tin sang hàng đợi của nhân viên bán hàng. Cách tách hai việc này hữu ích khi shop muốn sắp xếp 300 tin trong ngày nhưng chưa sẵn sàng cho AI tự hứa thời gian giao hoặc tự xử lý hoàn tiền.
Một nhãn hay nhiều nhãn Phân loại một nhãn phù hợp khi mỗi tin có một mục đích chính. Tin “mẫu này còn size M không ạ” có thể nhận `tu_van`, còn “chị lấy 2 cái màu đen” có thể nhận `chot_don`. Danh sách ban đầu thường gồm `hoi_gia`, `chot_don`, `khieu_nai`, `van_chuyen`, `tu_van` và `khac`; nhãn `khac` nên giữ lại để bắt những câu chưa có quy tắc rõ. Phân loại nhiều nhãn cần thiết khi một tin chứa từ hai yêu cầu trở lên, như “áo này bao nhiêu và giao về Đà Nẵng mấy ngày”. Ép câu này vào riêng `hoi_gia`
sẽ làm mất phần việc vận chuyển; hệ thống có thể trả `[`hoi_gia`, `van_chuyen`]` để hai nhóm cùng xử lý. Đây là khác biệt về cách biểu diễn dữ liệu, không phải yêu cầu AI phải viết câu trả lời dài hơn. Model nhẹ thường hợp với các ca lặp lại như nhận diện `hoi_gia` trong câu ngắn. Tin thiếu ngữ cảnh, viết tắt khó hiểu hoặc có cả khiếu nại và yêu cầu bồi hoàn nên chuyển sang kiểm tra tiếp. Một bài thử nghiệm trên SERP mô tả 50 tin mẫu, trong đó 40 tin thường được phân loại đúng và các tin nhiều ý cần bổ sung nhãn phụ; con số này chỉ là tham khảo, chưa phải phép đo cho dữ liệu shop Việt Nam
của bạn. Vì vậy, model có giá API thấp nhất chưa chắc là lựa chọn tiết kiệm nhất. Chi phí thực tế còn có tin gắn sai, lượt kiểm duyệt, công tích hợp và thời gian nhân viên sửa hàng trăm nhãn lỗi. Bài thử nghiệm nói trên ước tính khoảng 0,2 USD cho 1.000 tin, nhưng nguồn được đánh giá độ tin cậy thấp và chi phí API còn phụ thuộc token đầu vào, đầu ra; bạn nên đo trên mẫu thật trước khi chốt model.
Model AI cần làm được gì khi phân loại tin nhắn?
Một model phù hợp không chỉ gắn đúng nhãn “hỏi giá” hay “khiếu nại”; nó phải xử lý được tin tiếng Việt thật, trả dữ liệu máy đọc được và biết khi nào không nên tự quyết. Bạn nên kiểm tra model trên một tập tin nhắn có không dấu, teencode, lỗi gõ và tiếng địa phương, thay vì chỉ dùng câu tiếng Việt chuẩn. Ví dụ, “shop oi sp nay bn”, “hàng bị móp ib shop” và “ship về QN bao lâu” cần được đối chiếu với các nhãn như `hỏi giá`, `khiếu nại` và `vận chuyển`. Một bài thử nghiệm trên SERP dùng 50 tin mẫu, trong đó 40 tin thường được phân loại đúng; nguồn này cũng ghi nhận nhóm tin nhiều ý cần bổ sung ý phụ. Đây là số liệu tham khảo từ một thử nghiệm, chưa đủ để kết luận cho dữ liệu của shop bạn. Đầu ra nên bị giới hạn vào danh sách nhãn đã khai báo. Chẳng hạn, yêu cầu model trả đúng JSON theo cấu trúc `{“label”:”van_chuyen”,”secondary_labels”:[],”reason”:”Khách hỏi thời gian giao hàng”,”needs_review”:false}`; ứng dụng có thể từ chối kết quả nếu `label` không nằm trong enum hoặc JSON không parse được. Trường `secondary_labels` cần thiết với tin như “giá bao nhiêu, ship Đà Nẵng mấy ngày”, vì ép toàn bộ nội dung vào một nhãn có thể làm mất yêu cầu thứ hai.
Bộ tiêu chí kiểm tra Đừng chọn model chỉ vì giá niêm yết thấp. Chi phí API phụ thuộc vào token đầu vào và đầu ra; prompt dài, lịch sử hội thoại dài hoặc trường `reason` quá chi tiết đều làm tăng lượng token. Một nguồn SERP ước tính khoảng 0,2 USD cho 1.000 tin nhắn trong một cấu hình trả phí cụ thể, nhưng mức này có độ tin cậy thấp và không nên dùng thay bảng giá hiện hành. Hãy đo thêm số tin phải chuyển người duyệt, vì một model rẻ nhưng sai nhiều có thể tạo chi phí vận hành cao hơn.
| Tiêu chí | Cần kiểm tra | Ý nghĩa thực tế |
|---|---|---|
| Tiếng Việt | Không dấu, teencode, lỗi chính tả, tiếng địa phương | Đối chiếu với tin thật từ fanpage, website hoặc sàn |
| Định dạng đầu ra | JSON hợp lệ, nhãn cố định, `reason` và `needs_review` | Nối được với CRM, n8n hoặc bảng dữ liệu |
| Tin nhiều ý | Có `secondary_labels` hoặc cờ cần xem lại | Không bỏ sót yêu cầu phụ trong cùng một tin |
| Tốc độ và ngữ cảnh | Đo thời gian phản hồi, độ dài prompt và tin đầu vào | Biết có xử lý được hàng loạt hay không |
| Fallback | Quy tắc khi JSON lỗi, nhãn lạ hoặc model không chắc chắn | Chuyển sang model mạnh hơn hoặc người duyệt |
Workflow phân loại tin nhắn bằng AI: từ dữ liệu đến nhãn
Một workflow phân loại tin nhắn đáng tin bắt đầu từ dữ liệu sạch, nhãn cố định và một đường lui rõ ràng cho ca khó. Bạn không nên gửi nguyên văn số điện thoại, địa chỉ hoặc mã đơn lên API nếu chúng không cần cho việc gắn nhãn.
Các bước triển khai
| Bước | Mô tả | API / Node |
|---|---|---|
| 1 | Thu thập, làm sạch và ẩn thông tin cá nhân | Input, Code hoặc Set |
| 2 | Khai báo nhãn, ví dụ và định dạng JSON | Prompt hoặc Chat Model |
| 3 | Gửi tin đơn giản tới model nhẹ | HTTP Request hoặc AI node |
| 4 | Kiểm tra JSON, nhãn và điều kiện confidence | IF, Structured Output hoặc Code |
| 5 | Chuyển ca khó tới người duyệt hoặc model khác | IF, webhook hoặc email |
| 6 | Lưu kết quả và nhãn chuẩn để đánh giá | Database, Google Sheets hoặc CRM |
Giá, lỗi thường gặp và khi nào không nên dùng model nhẹ
Model nhẹ có thể rẻ ở mỗi lượt gọi, nhưng tổng chi phí còn gồm token, hạ tầng workflow và nhân sự kiểm duyệt. Một thử nghiệm được mô tả trên SERP ước tính khoảng 0,2 USD cho 1.000 tin nhắn theo bảng giá tham khảo; con số này có độ tin cậy thấp, nên bạn chỉ dùng làm mốc ban đầu, không xem là báo giá cố định. Chi phí token tăng khi tin khách dài, prompt chứa nhiều ví dụ hoặc model phải trả lời bằng đoạn giải thích dài thay vì JSON ngắn. Chẳng hạn, yêu cầu chỉ trả `{“label”:”van_chuyen”}` sẽ khác về lượng đầu ra so với việc bắt model viết thêm lý do, mức độ chắc chắn và hướng trả lời. Ngoài API, workflow còn có phí máy chủ, queue, log, retry và kết nối CRM. Nhân sự phải đọc lại các tin bị gắn nhãn sai; khoản này có thể lớn hơn phần tiền API tiết kiệm.
Các lỗi cần tính trước Tin mỉa mai như “shop giao nhanh ghê, đặt từ tuần trước rồi”, tin viết tắt, không dấu, sai chính tả hoặc trộn Việt-Anh dễ bị xếp nhầm giữa `khieu_nai`, `van_chuyen` và `khac`. Một tin vừa hỏi giá vừa hỏi thời gian giao cũng có thể không phù hợp với thiết kế một nhãn. Một thử nghiệm trên 50 tin
được SERP mô tả ghi nhận 40 tin thường được phân loại đúng, còn nhóm nhiều ý cần bổ sung ý phụ; đây không phải benchmark độc lập cho mọi shop. Không dùng model nhẹ làm bộ lọc duy nhất cho khiếu nại nghiêm trọng, yêu cầu hoàn tiền lớn hoặc nguy cơ liên quan pháp lý. Hãy thử trên dữ liệu thật, đo riêng từng nhãn rồi chọn ngưỡng chuyển người duyệt dựa trên tỷ lệ sai chấp nhận được; không nên tự đặt `0,8` hay `0,9` khi chưa có phép đo. Trước khi gửi, xử lý số điện thoại, địa chỉ, mã đơn và tên khách bằng bước ẩn hoặc thay thế token. Nếu dữ liệu quá ít, danh sách nhãn còn mơ hồ, hoặc hậu quả
của một nhãn sai quá lớn, chi phí sửa đơn, xin lỗi và xử lý khiếu nại có thể vượt xa tiền gọi API.
Hai tình huống dùng thật tại Việt Nam
Shop nhận tin từ fanpage Một shop bán mỹ phẩm qua fanpage thường nhận cùng lúc tin hỏi giá, hỏi tồn kho, chốt đơn và hỏi phí vận chuyển. Bạn có thể gắn mỗi tin vào một hàng đợi trước khi nhân viên mở hộp thư: `pricing`, `inventory`, `order` hoặc `shipping`. Tin như “serum này còn không, ship về Đà Nẵng bao lâu” có hai ý; nên đưa vào hàng `review` thay vì ép vào một nhãn duy nhất. Luồng xử lý này không cần để AI tự trả lời khách. AI chỉ trả về nhãn, mã cuộc hội thoại và mức cần kiểm tra; nhân viên phụ trách hàng `order` mới xác nhận thông tin đơn. Tin có nhiều sản phẩm, yêu cầu đổi trả hoặc nhắc đến hoàn tiền nên chuyển thẳng cho người duyệt. Các nhãn này có thể nối với CRM, công cụ quản lý đơn hoặc workflow đăng bài, nhưng tên trường cần thống nhất, chẳng hạn `intent=return_request` và `review_required=true`.
Doanh nghiệp phân tuyến chăm sóc khách hàng Một đội chăm sóc khách hàng cần tách ít nhất bốn nhóm: tư vấn sản phẩm, khiếu nại, bảo hành và theo dõi đơn. Tin “máy lọc nước lỗi từ hôm qua, cho tôi hỏi bảo hành thế nào” vừa có dấu hiệu khiếu nại vừa liên quan bảo hành, nên
được gửi đến hàng review hoặc nhóm có quyền xử lý cả hai loại. Trước khi chạy thử, hãy tạo tập mẫu đã ẩn tên, số điện thoại, địa chỉ và mã đơn; sau đó gán nhãn thủ công làm chuẩn đối chiếu. Bạn có thể bắt đầu với 50 tin, lưu cả nhãn AI và nhãn người duyệt, rồi so sánh từng nhóm thay vì chỉ nhìn một con số chung. Một bài thử nghiệm được nêu trên SERP ghi nhận 40/50 tin thường được phân loại đúng bằng Gemini 3.5 Flash-Lite, nhưng đây không phải số liệu thử nghiệm
của bài này. Báo cáo nên có độ chính xác theo từng nhãn, tỷ lệ review, thời gian xử lý mỗi tin và chi phí trên 1.000 tin. Chi phí tham khảo khoảng 0,2 USD/1.000 tin từng được nêu trên SERP, nhưng chi phí thật còn phụ thuộc số token đầu vào và đầu ra. Khung trên chỉ là mẫu minh họa: dùng kết quả để sửa danh sách nhãn, prompt và ví dụ đầu vào, không dùng nó như cam kết kết quả.
Đưa workflow phân loại tin nhắn vào RevidAPI
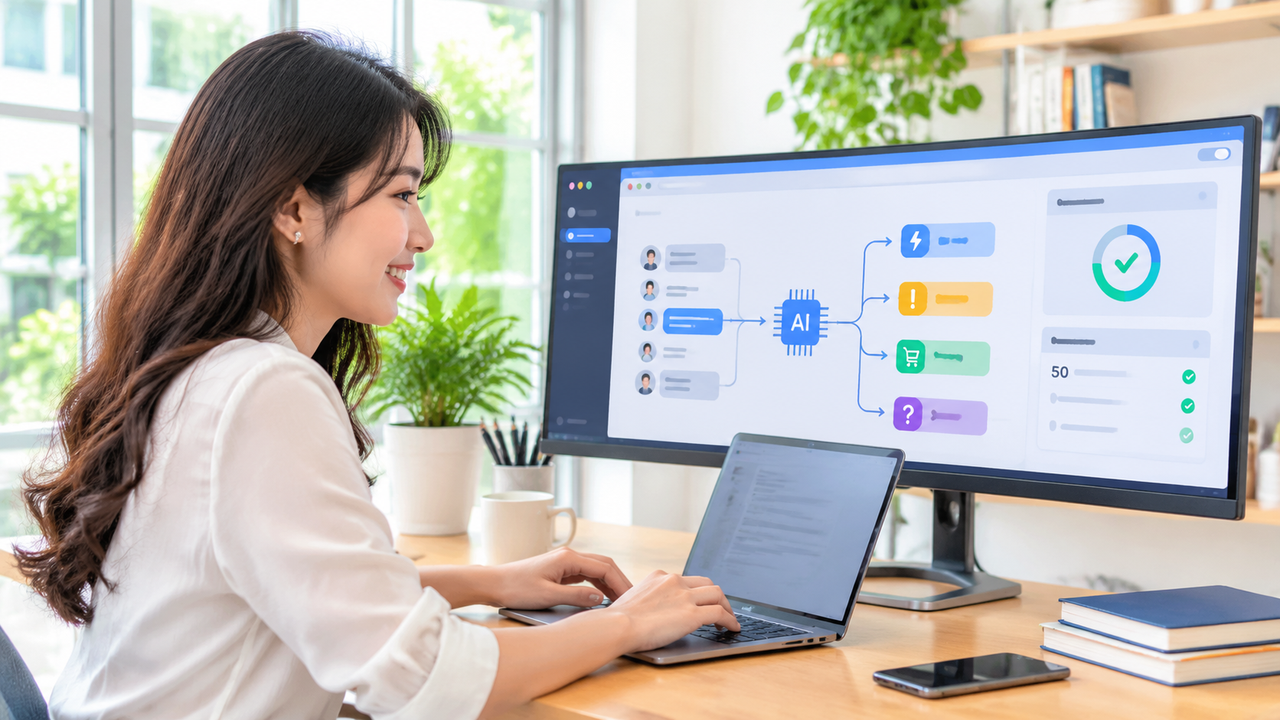
Một workflow phân loại tin nhắn nên bắt đầu với khoảng 50 mẫu đã ẩn số điện thoại, tên và mã đơn hàng, rồi mới tăng khối lượng. Một thử nghiệm được trích trên SERP dùng 50 tin và ghi nhận 40 tin thường được phân loại đúng; con số này chỉ nên xem là tham khảo, không phải benchmark cho dữ liệu của bạn.
Dựng workflow và kiểm tra nhãn Trong AI Studio Workflow, bạn có thể kéo node nhận dữ liệu, node gọi model và node kiểm tra JSON thành một luồng nhỏ. Khai báo cố định sáu nhãn `hoi_gia`, `chot_don`, `khieu_nai`, `van_chuyen`, `tu_van`, `khac`; mỗi tin chỉ
được trả một nhãn, còn tin vừa hỏi giá vừa hỏi thời gian giao phải đi vào nhánh kiểm tra thủ công. Node kiểm tra cần xử lý ít nhất ba lỗi: JSON không parse được, nhãn nằm ngoài danh sách và tin có nhiều ý. Với lỗi đầu tiên, giữ nguyên nội dung đã ẩn thông tin cá nhân rồi đưa sang người duyệt; với hai lỗi sau, gắn trạng thái `needs_review` thay vì tự đoán. Theo dõi số credit và lịch sử tại Credit & Lịch sử dùng, còn model và đơn giá cần kiểm tra tại Bảng giá AI Studio. Khi workflow cần đọc dữ liệu từ CRM, Google Sheets hoặc webhook, bạn có thể dùng n8n Hosting hoặc import JSON n8n. API key phải nằm trong credential hoặc biến môi trường
của n8n, không đặt trực tiếp trong node công khai. Dữ liệu gửi đi cũng nên là bản đã loại bỏ tên, số điện thoại và mã đơn hàng.
Gọi model qua endpoint chính thức RevidAPI xác nhận endpoint tương thích OpenAI là `POST https://revidapi.com/v1/chat/completions`; header dùng `Authorization: Bearer` hoặc `x-api-key`. Danh sách model và giá có thể lấy bằng `GET https://revidapi.com/v1/chat/models` trước khi chọn model nhẹ cho tin đơn giản.
const response = await fetch("https://revidapi.com/v1/chat/completions", { method: "POST", headers: { "Authorization": `Bearer ${process.env.REVIDAPI_KEY}`, "Content-Type": "application/json" }, body: JSON.stringify({ model: "claude-sonnet-5", messages: [ { role: "system", content: "Trả JSON với nhãn: hoi_gia, chot_don, khieu_nai, van_chuyen, tu_van, khac. Nếu tin nhiều ý, dùng needs_review." }, { role: "user", content: message } ] })
}); const result = await response.json();
const content = result.choices?.[0]?.message?.content ?? "";
let classification;
try { classification = JSON.parse(content);
} catch { classification = { label: "needs_review", raw: content };
}
const response = await fetch("https://revidapi.com/v1/chat/completions", { method: "POST", headers: { "Authorization": `Bearer ${process.env.REVIDAPI_KEY}`, "Content-Type": "application/json" }, body: JSON.stringify({ model: "claude-sonnet-5", messages: [ { role: "system", content: "Trả JSON với nhãn: hoi_gia, chot_don, khieu_nai, van_chuyen, tu_van, khac. Nếu tin nhiều ý, dùng needs_review." }, { role: "user", content: message } ] })
}); const result = await response.json();
const content = result.choices?.[0]?.message?.content ?? "";
let classification;
try { classification = JSON.parse(content);
} catch { classification = { label: "needs_review", raw: content };
}Đoạn mã dùng `claude-sonnet-5` theo endpoint đã xác nhận, nhưng bạn vẫn nên đối chiếu `GET /v1/chat/models` và bảng giá trước khi chạy hàng loạt. Chi phí phụ thuộc token đầu vào và đầu ra, nên prompt ngắn, nhãn cố định và nhánh người duyệt thường dễ kiểm soát hơn việc yêu cầu model giải thích dài.
Câu hỏi thường gặp về phân loại tin nhắn khách hàng bằng AI
Model AI nào rẻ nhất để phân loại tin nhắn khách hàng?
Chưa thể gọi một model là rẻ nhất nếu chưa đo cùng tập tin tiếng Việt, số token và tỷ lệ phải sửa nhãn. Model nhẹ thường hợp với tin lặp lại như hỏi giá hoặc vận chuyển; tin khiếu nại, viết tắt nhiều hoặc thiếu ngữ cảnh nên chuyển sang model mạnh hơn hoặc người duyệt. Một thử nghiệm
được nêu trên SERP phân loại đúng 40/50 tin mẫu, nhưng đây chưa phải benchmark đủ để chọn model cho dữ liệu của bạn.
Chi phí phân loại 1.000 tin nhắn tính thế nào?
Bạn cần tính số tin, độ dài đầu vào, độ dài JSON đầu ra và bảng giá hiện hành. Một bài thử nghiệm ước tính khoảng 0,2 USD cho 1.000 tin nhắn, nhưng nguồn này có độ tin cậy thấp và con số thực tế thay đổi khi prompt hoặc nội dung dài hơn. Hãy chạy 100 tin thật, ghi token đầu vào và đầu ra, rồi nhân theo khối lượng dự kiến; thêm chi phí kiểm duyệt các ca sai.
Có nên dùng model AI miễn phí cho dữ liệu khách hàng không? Chỉ nên dùng
sau khi đã ẩn tên, số điện thoại, địa chỉ, mã đơn và thông tin nhận diện khác. Gói miễn phí có thể có giới hạn lưu trữ, huấn luyện hoặc quyền sử dụng dữ liệu khác nhau; hãy kiểm tra chính sách hiện hành trước khi gửi tin khách thật. Bạn có thể bắt đầu bằng 20–50 tin đã ẩn danh để kiểm tra định dạng JSON và nhãn.
Làm gì khi một tin nhắn có nhiều ý?
Đừng ép câu “áo này bao nhiêu, giao Hà Nội mấy ngày” vào một nhãn duy nhất. Cho phép mảng nhãn như `gia` và `van_chuyen`, hoặc gắn cờ `can_duyet=true` khi hệ thống không xác định
được ý chính; các nhóm hỏi giá, chốt đơn và khiếu nại có thể cần cách xử lý khác nhau.
Có thể tự động hóa workflow bằng n8n và RevidAPI không?
Có thể nối n8n qua node HTTP Request tới `POST https://revidapi.com/v1/chat/completions`, gửi `model` và `messages`, kèm header `x-api-key: YOUR_API_KEY`; danh sách model lấy từ `GET https://revidapi.com/v1/chat/models`. Node n8n cụ thể và mức credit cần
được xác nhận trong tài liệu hiện hành, nên hãy thử với dữ liệu nhỏ, đo lỗi rồi mới tăng mức tự động hóa.
Khám phá workflow miễn phí tại AI Tạo ảnh & Video và lấy API key tại API Marketplace RevidAPI.
Khám phá API Marketplace RevidAPI — lấy API key miễn phí · Nhóm Zalo hỗ trợ · revidapi@gmail.com