


Nếu ưu tiên chi phí và coding, Claude Opus 5.5 đang có lợi thế tham khảo; GPT-6 Astra chỉ nên chọn sau khi xác minh giá, tốc độ và tài liệu API. Bài này giúp bạn đối chiếu hai model theo workflow lập trình thật: cùng một prompt cho sinh code, sửa lỗi và viết test; sau đó chạy mã, ghi token, latency và số lần phải yêu cầu làm lại. Các mức giá và điểm benchmark chỉ là dữ liệu tham khảo tại thời điểm nguồn được kiểm tra, không phải cam kết cho mọi tài khoản hoặc ngôn ngữ.
Tóm tắt nhanh
- Giá
được một nguồn SERP phân tích ở mức Claude Opus 5.5: 4 USD input và 20 USD output trên mỗi 1 triệu token; GPT-6 Astra: 10 và 50 USD, nhưng cần kiểm tra lại trước khi lập ngân sách.
- BenchLM hiển thị điểm coding ước tính 83,3 cho Claude Opus 5.5 và 74 cho GPT-6 Astra, đồng thời cảnh báo độ tin cậy xếp hạng còn hạn chế.
- Chưa có số tốc độ đủ chắc để kết luận model nào nhanh hơn; hãy đo thời gian phản hồi, token và tỷ lệ test đạt bằng cùng bộ đầu vào trước khi đưa vào production.
Claude Opus 5.5 và GPT-6 Astra là gì? *(180–250 từ)*
Claude Opus 5.5 và GPT-6 Astra là hai model đang được đặt cạnh nhau trên SERP để so sánh khả năng coding, chi phí API và hiệu năng thực tế.
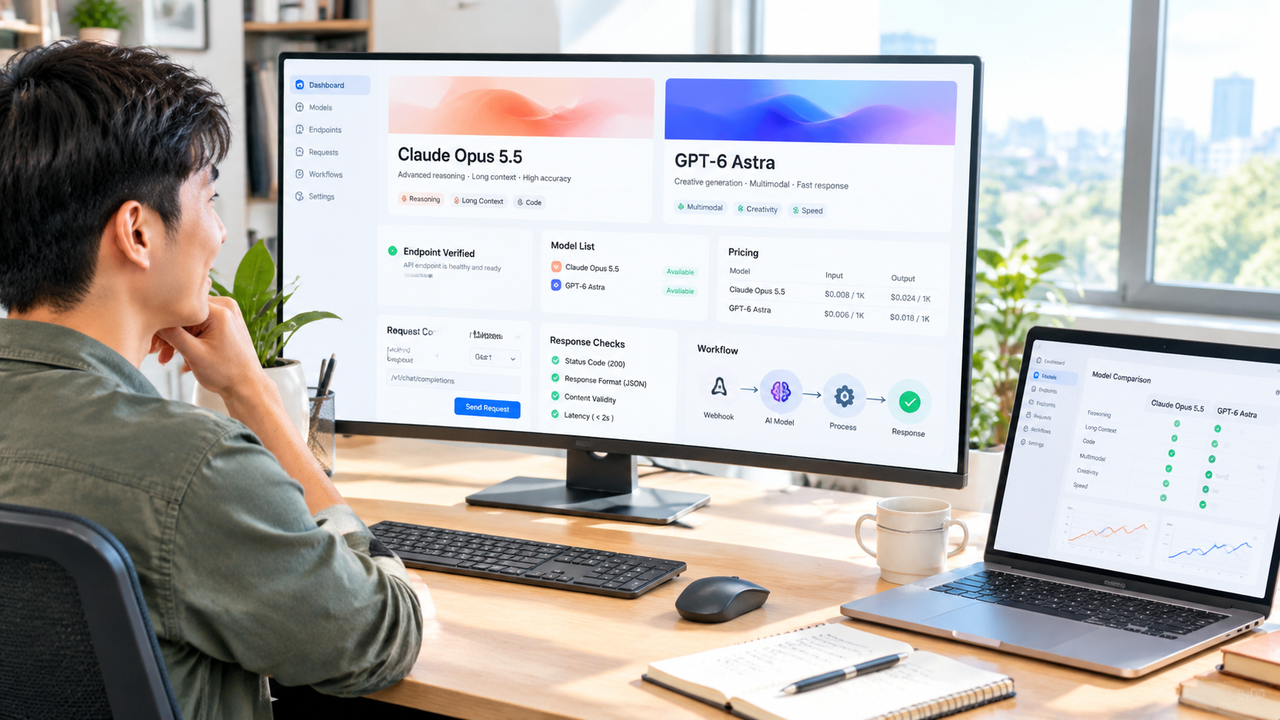
Phạm vi đối chiếu Trong bài này, “so sánh” không chỉ là đọc điểm benchmark. Bạn có thể xem hai model như các lựa chọn gọi qua API cho ba nhóm việc: sinh hoặc sửa mã, automation nhiều bước, và xử lý nội dung đa phương tiện có thành phần lập trình. Một workflow cụ thể có thể là nhận yêu cầu từ webhook, gửi prompt kèm log lỗi, nhận diff mã rồi chạy test trước khi chấp nhận bản sửa. Thông tin cần tách thành hai lớp. Tài liệu chính thức
của nhà cung cấp mới là căn cứ để xác nhận endpoint, model ID, giới hạn context hoặc chính sách giá. Ngược lại, LLM Stats và DocsBot chủ yếu giúp đặt hai model cạnh nhau; BenchLM đưa ra điểm coding ước tính 83,3 cho Claude Opus 5.5 và 74 cho GPT-6 Astra, nhưng cũng cảnh báo độ tin cậy xếp hạng còn hạn chế. Artificial Analysis có thể dùng như nguồn đối chiếu thứ tư, không thay thế tài liệu gốc. Các con số trên SERP, gồm giá token, benchmark và thông số hiệu năng, có thể đổi theo thời điểm kiểm tra hoặc phiên bản model. Vì vậy, đừng lấy một điểm 83,3 để quyết định triển khai production; hãy kiểm tra lại trang giá, tài liệu API và cùng một bộ prompt, test, log trước khi chọn model cho dự án.
So sánh giá, tốc độ và tính năng cốt lõi theo dữ liệu đã xác minh *(350–450 từ)*
Chọn model cho từng workflow lập trình và kiểm thử trước triển khai *(300–400 từ)*
Nếu ngân sách là tiêu chí đầu tiên, hãy thử Claude Opus 5.5 cho sinh code và refactor; GPT-6 Astra chỉ nên được chọn sau khi đo tốc độ, chất lượng và chi phí trên chính workflow của bạn. Mức tham khảo trong dữ liệu nghiên cứu là 4/20 USD cho mỗi 1 triệu token input/output của Claude, so với 10/50 USD của GPT-6 Astra; tốc độ thực tế chưa có số liệu đủ chắc để kết luận.
Quy trình thử trong một repository
| Bước | Mô tả | API / Node | Ghi chú |
|---|---|---|---|
| 6. Chạy lại workflow mẫu trên nhánh riêng trước production. Chỉ triển khai khi mã qua test, không lộ secret, diff nằm trong phạm vi issue và chi phí mỗi lượt phù hợp ngân sách. | Workflow | Kiểm tra ngay | Chỉ số quyết định |
| Sinh code, refactor | Cùng prompt, cùng repository | Test pass, số file đổi, diff ngoài phạm vi | |
| Debug | Log + test thất bại + patch | Tái hiện đúng lỗi, không tạo regression | |
| Tạo test, tài liệu | Ba nhóm input và edge case | Test bắt được lỗi cố ý, tài liệu có ví dụ chạy | |
| Automation nhiều bước | Một nhánh xử lý lỗi trong n8n | Truyền đúng trạng thái, dừng đúng điều kiện | |
| Giảm chi phí | Ghi token và số lần retry | USD mỗi lượt, p50/p95 latency | |
| Quyết định triển khai | Chạy toàn workflow trên staging | Chất lượng mã, lỗi bảo mật, thời gian hoàn thành | Kết quả nên được lưu thành một file CSV hoặc bảng log có `model`, `prompt_version`, `commit_sha` và `run_id`. Cách này cho phép bạn đổi prompt hoặc model mà vẫn so sánh được cùng một bộ đầu vào, thay vì chọn theo một điểm benchmark đơn lẻ. |
Hạn chế và rủi ro khi đọc benchmark, giá API và mã sinh ra *(220–300 từ)*
Một điểm coding không phải lời hứa về kết quả trong repo của bạn. BenchLM hiện hiển thị Claude Opus 5.5 ở mức 83,3 và GPT-6 Astra ở mức 74, nhưng cũng cảnh báo độ tin cậy của thứ hạng còn hạn chế.
Đọc benchmark cùng phương pháp đo Hai nguồn có thể dùng prompt, bộ dữ liệu và cách chấm khác nhau. Vì vậy, 83,3 không thể
được dùng để suy ra Claude luôn tốt hơn khi viết Go, sửa một ứng dụng Laravel hay xử lý codebase nhiều module. Hãy kiểm tra prompt, phiên bản model, số lượt chạy và tiêu chí chấm trước khi so sánh. Với dữ liệu hiện có, tốc độ phản hồi chưa có số đo đủ rõ để chọn model chỉ từ bảng xếp hạng. Giá cũng chỉ là ảnh chụp theo thời điểm. Một bài phân tích SERP ghi nhận Claude Opus 5.5 ở mức 4 USD input và 20 USD output trên một triệu token, còn GPT-6 Astra ở mức 10 USD và 50 USD; cache read lần lượt là 0,20 USD và 1 USD. Đây là dữ liệu tham khảo, không thay cho bảng giá và giới hạn tốc độ hiện hành
của nhà cung cấp. Chính sách API, quota hoặc giá có thể đổi sau ngày kiểm tra.
| Rủi ro | Ví dụ cụ thể | Cách kiểm tra |
|---|---|---|
| Benchmark lệch bối cảnh | Điểm 83,3 nhưng chưa nói rõ repo và ngôn ngữ | Chạy cùng prompt trên cùng commit |
| Mã sinh ra có lỗi | Hàm chạy được nhưng thiếu test biên hoặc kéo dependency rủi ro | Chạy test, review diff, quét dependency |
| Lộ dữ liệu | Prompt chứa `OPENAI_API_KEY`, secret hoặc dữ liệu khách hàng | Redact trước khi gửi, giới hạn log và xoay key |
Ứng dụng thực tế cho developer và creator Việt Nam *(250–350 từ)*
Một developer freelance có thể dựng prototype bằng một endpoint chat để nhận yêu cầu, sinh hàm xử lý CSV và tạo luôn test unit. Cùng một prompt, bạn gửi cho Claude Opus 5.5 và GPT-6 Astra, lưu input, output, thời gian phản hồi và số lần sửa vào JSONL. Chỉ đưa mã vào nhánh thử nghiệm sau khi chạy `pytest`, kiểm tra lỗi bảo mật cơ bản và review diff thủ công. Với n8n, workflow có thể bắt đầu từ webhook nhận file `.csv`, gọi model để tạo mã biến đổi dữ liệu, ghi kết quả vào kho nội bộ rồi dừng ở node phê duyệt. Người duyệt kiểm tra trường dữ liệu nhạy cảm trước khi cho chạy bước cuối. AI Studio phù hợp với người muốn kéo-thả các bước như nhập transcript, gọi model dịch tiếng Việt, tạo bản nháp và xuất trạng thái `approved`; bạn vẫn cần kiểm tra giới hạn request và cách lưu secret của từng nền tảng.
Hai tình huống thử nghiệm Một shop online có 200 mô tả sản phẩm tiếng Việt có thể lấy 20 mô tả làm mẫu, yêu cầu model chuẩn hóa tiêu đề, sinh mã xử lý dữ liệu và tạo test cho các trường rỗng. Không nên kết luận model nào nhanh hơn từ một lần chạy; hãy lặp cùng prompt, cùng kích thước đầu vào và ghi latency thực tế. Một creator nhận transcript
của 10 video, mỗi video dài 3–5 phút, rồi chạy các bước: dịch sang tiếng Việt, tạo giọng đọc, dubbing, lipsync, ghép bản nháp và tải video xuống để duyệt. Giả định thử nghiệm là một ngôn ngữ nguồn, một giọng đích và ngân sách cố định do bạn đặt trước; bài này chưa có số đo về tốc độ, tỷ lệ lỗi hay chi phí pipeline đó. Trong cả hai trường hợp, hãy chia ngân sách thành lượt thử và lượt chạy lại. Developer có thể chấm mã theo test pass, số chỉnh sửa và lỗi dữ liệu; creator chấm transcript, phát âm, đồng bộ môi và các đoạn cần sửa trước khi xuất bản. Kết quả này thực tế hơn việc lấy điểm coding 83,3 so với 74 từ BenchLM làm quyết định triển khai duy nhất.
Pro-tips triển khai workflow với RevidAPI và endpoint đã xác minh *(250–350 từ)*
Bắt đầu từ model đã xác minh
Tạo API key tại RevidAPI Dashboard, sau đó gọi `GET https://revidapi.com/v1/chat/models` để đọc danh sách model và giá hiện hành. Bài so sánh có thể đề cập Claude Opus 5.5 và GPT-6 Astra, nhưng không nên điền hai tên này vào request nếu endpoint chưa trả về chúng. Với workflow coding, dùng cùng một prompt, cùng bộ test và ghi lại model, số token, thời gian phản hồi, số lần chạy lại.
Gọi LLM bằng request tối thiểu
Endpoint tương thích OpenAI là `POST https://revidapi.com/v1/chat/completions`. Header bắt buộc gồm `x-api-key: YOUR_API_KEY` và `Content-Type: application/json`; chuỗi `YOUR_API_KEY` chỉ là giá trị giả lập.
curl https://revidapi.com/v1/chat/completions \ -H "x-api-key: YOUR_API_KEY" \ -H "Content-Type: application/json" \ -d '{"model":"claude-sonnet-5","messages":[{"role":"user","content":"Refactor hàm này và trả về diff cùng test tương ứng."}]}'`claude-sonnet-5` là model có trong endpoint mẫu đã xác minh, không phải bằng chứng RevidAPI hỗ trợ hai model đang được so sánh. Muốn biết giá theo token, đọc phản hồi của `GET /v1/chat/models` thay vì sao chép giá từ trang so sánh.
Đưa vào workflow kiểm thử
Trong n8n, bạn có thể import JSON tại `n8n.revidapi.com`; với AI Studio, kéo một node nhận webhook, một node gọi LLM và một node chạy kiểm tra đầu ra. Mỗi nhánh nên nhận cùng file code và log gồm mã HTTP, nội dung phản hồi, token cùng thời gian bắt đầu và kết thúc. Một workflow thực tế có thể yêu cầu model sửa một lỗi, chạy test, rồi gửi kết quả cho bước duyệt thủ công trước khi tạo pull request. Khi cần công cụ ngoài, kiểm tra AI & MCP Integrations trước khi nối node. Hãy thử workflow trên 5–10 ca lỗi đã lưu của dự án; chúng tôi chưa có số đo độc lập để khẳng định model nào nhanh hơn trong RevidAPI, nên quyết định triển khai phải dựa trên log của chính bạn.
FAQ: Claude Opus 5.5 vs GPT-6 Astra *(200–300 từ)*
Claude Opus 5.5 hay GPT-6 Astra rẻ hơn?
Chưa nên chốt model nào rẻ hơn nếu chưa kiểm tra bảng giá chính thức tại thời điểm bạn triển khai. Mức 4/20 USD cho Claude Opus 5.5 và 10/50 USD cho GPT-6 Astra trên mỗi 1 triệu token chỉ là số liệu từ bài phân tích SERP, chưa đủ làm căn cứ thanh toán.
Model nào phù hợp coding hơn?
Claude Opus 5.5 có điểm coding tham khảo 83,3, còn GPT-6 Astra là 74 trên BenchLM; chính nguồn này cũng cảnh báo độ tin cậy xếp hạng còn hạn chế. Với repository thật, hãy dùng cùng prompt cho một task refactor hoặc sửa test thất bại rồi review diff, lỗi bảo mật và số lần chạy lại.
Model nào phản hồi nhanh hơn?
Chưa có số liệu latency đủ tin cậy để kết luận. Bạn nên ghi thời gian từ lúc gửi request đến token cuối, cùng prompt, kích thước context và tải đồng thời; tối thiểu tách riêng thời gian chờ hàng đợi với thời gian sinh output.
Có nên đưa mã sản xuất cho model không?
Chỉ gửi phần mã cần thiết cho task, loại API key, cookie, dữ liệu khách hàng và biến môi trường trước khi gọi model. Với log lỗi, thay giá trị thật bằng placeholder như `DB_PASSWORD=REDACTED`, sau đó kiểm tra quyền lưu và quyền truy cập bản ghi prompt.
Kiểm thử workflow ở đâu trước triển khai?
Chạy prototype bằng API, n8n hoặc AI Studio với dữ liệu mẫu và test hồi quy. Nếu thử qua RevidAPI, xem tài liệu tại `https://revidapi.com/dashboard/docs` và xác minh model trong `GET https://revidapi.com/v1/chat/models` trước khi gửi request chat.
Khám phá workflow miễn phí tại AI Tạo ảnh & Video và lấy API key tại API Marketplace RevidAPI.
Khám phá API Marketplace RevidAPI — lấy API key miễn phí · Nhóm Zalo hỗ trợ · revidapi@gmail.com